
Luna, Sol czy Astra? Ile naprawdę kosztuje GPT-6 w API
GPT-6 API cena w złotówkach: stawki Luna, Sol i Astra za 1 mln tokenów, kiedy który model, jak policzyć koszt zapytania, kod Python, Node i curl.
 Piotr Olszewski2026-10-226 minEnglish
Rodzina GPT-6 to trzy szczeble cenowe. Najtańsza jest GPT-6 Luna (0,587 zł / 2,93 zł za 1 mln tokenów), środek to GPT-6 Sol (11,73 zł / 58,65 zł za 1 mln tokenów), a na górze stoi GPT-6 Astra (58,65 zł / 293,27 zł za 1 mln tokenów). W Kadrarisie płacisz z salda w złotych brutto, doładowanego BLIK-iem, bez abonamentu, z fakturą na firmę, jeśli ją zaznaczysz. Mój domyślny układ: Sol do codziennej pracy, Luna do zadań hurtowych, Astra tylko tam, gdzie Sol zawodzi.
Poniżej: czym się różnią, jak policzyć koszt jednego zapytania i jak w kilka minut podpiąć GPT-6 do swojego kodu.
Zasada wyboru, zanim zajrzysz w cennik
Zaczynam od najtańszego modelu, który daje akceptowalne wyniki, i podnoszę poziom tylko dla przypadków, które tego potrzebują.
- Luna - krótkie, powtarzalne zadania: tagowanie zgłoszeń, wyciąganie danych z maili i faktur, pierwsza odpowiedź na czacie, streszczenia.
- Sol - zadania wymagające myślenia: pisanie i poprawianie kodu, plan migracji, porównywanie umów, agent wołający kilka narzędzi.
- Astra - gdy Sol nie przechodzi twoich trudnych przypadków albo błąd kosztuje więcej niż różnica w stawce: przegląd architektury, analiza ryzyka, ostateczna weryfikacja odpowiedzi tańszych modeli.
Jak to sprawdzić na własnych danych? Zbierz 20-50 prawdziwych przykładów z projektu, puść je przez Lunę i Sol, zestaw odpowiedzi i koszty. Jeśli Luna radzi sobie w dziewięciu przypadkach na dziesięć, zwykle opłaca się kierować do niej cały ruch, a resztę eskalować do Sol. Skrypt do równoległego testu kilku modeli pokazuję w poradniku jedno API do GPT, Claude i Gemini.
Trzy modele w liczbach
OpenAI wypuścił GPT-6 we wrześniu 2026: Astrę 3 września, Sol i Lunę 22 września. Według producenta tańsze modele trenowano podobnymi metodami co Astrę, żeby przenieść jej postęp niżej. Wszystkie przyjmują tekst i obrazy, odpowiadają tekstem, mają kontekst 1,05 mln tokenów i odpowiedź do 128 tys. tokenów.
| Model | Identyfikator | Stawka za 1 mln tokenów (wejście / wyjście) | Główne zastosowanie |
|---|---|---|---|
| GPT-6 Astra | gpt-6-astra | 58,65 zł / 293,27 zł za 1 mln tokenów | najtrudniejsze problemy, długie projekty kodu, nauka |
| GPT-6 Sol | gpt-6-sol | 11,73 zł / 58,65 zł za 1 mln tokenów | kod, agenci, analiza dokumentów |
| GPT-6 Luna | gpt-6-luna | 0,587 zł / 2,93 zł za 1 mln tokenów | czat, klasyfikacja, streszczenia |
Między Luną a Astrą są dwa rzędy wielkości. Przy kilku zapytaniach to bez znaczenia, przy tysiącach dziennie decyduje o tym, czy projekt się spina finansowo.
Astra: flagowiec z jednym haczykiem
OpenAI wymienia jej mocne strony: programowanie, obsługa komputera, przeglądanie stron, cyberbezpieczeństwo, nauka, praca zawodowa. Sens ma tam, gdzie lepsza odpowiedź oszczędza godziny człowieka. Haczyk z changelogu OpenAI: Astra nie przyjmuje własnych wartości temperature ani top_p. Przenosząc stary kod, usuń te pola.
Sol: koń roboczy
Producent ustawia Sol jako model do wymagającej pracy, przy której chcesz iterować wiele razy bez płacenia stawki flagowca. U mnie to pierwszy wybór do kodu, agentów z narzędziami i długich dokumentów.
Luna: szybka i tania
Polecana do czatu, klasyfikacji i lekkich agentów. Ma ten sam kontekst co Sol, więc przeczyta długi log czy raport - po prostu wyciągnie z niego płytsze wnioski.
GPT-6.1 Sol
29 września OpenAI wydał GPT-6.1 Sol jako nowszą odsłonę Sol w tej samej cenie bazowej. W chwili pisania katalog Kadrarisa ma gpt-6-sol. Bieżącą listę znajdziesz w katalogu modeli albo pod GET /v1/models?category=chat. Gdy nowa wersja się pojawi, w kodzie zmienisz tylko wartość model.
Liczenie kosztu zapytania
Stawki są za milion tokenów, osobno za wejście (prompt systemowy, historia, dokumenty) i wyjście (tekst modelu):
koszt = wejście / 1 000 000 x stawka wejścia
      + wyjście / 1 000 000 x stawka wyjścia
Przykład: dokument na 20 tys. tokenów i odpowiedź na 2 tys. to 0,02 x stawka wejścia + 0,002 x stawka wyjścia. Stawki masz w tabeli wyżej.
Co podbija rachunek bardziej, niż się spodziewasz:
- Myślenie modelu. GPT-6 to modele rozumujące. Tokeny rozumowania liczą się jako wyjście, więc krótka odpowiedź na trudne pytanie może kosztować jak długa.
- Rosnąca rozmowa. W czacie każde zapytanie niesie całą dotychczasową historię. Dziesiąta wiadomość płaci jako wejście za dziewięć poprzednich.
- Wielkie okno. 1,05 mln tokenów kusi, by wrzucić całe repozytorium. Każdy token wejścia jest płatny, więc wycinaj to, czego model nie potrzebuje.
Realne zużycie zwraca pole usage w każdej odpowiedzi (prompt_tokens, completion_tokens) - za te liczby płacisz. Miesięczny rachunek dla swojego ruchu oszacujesz w kalkulatorze kosztów AI.
Podłączenie: Python, Node, curl
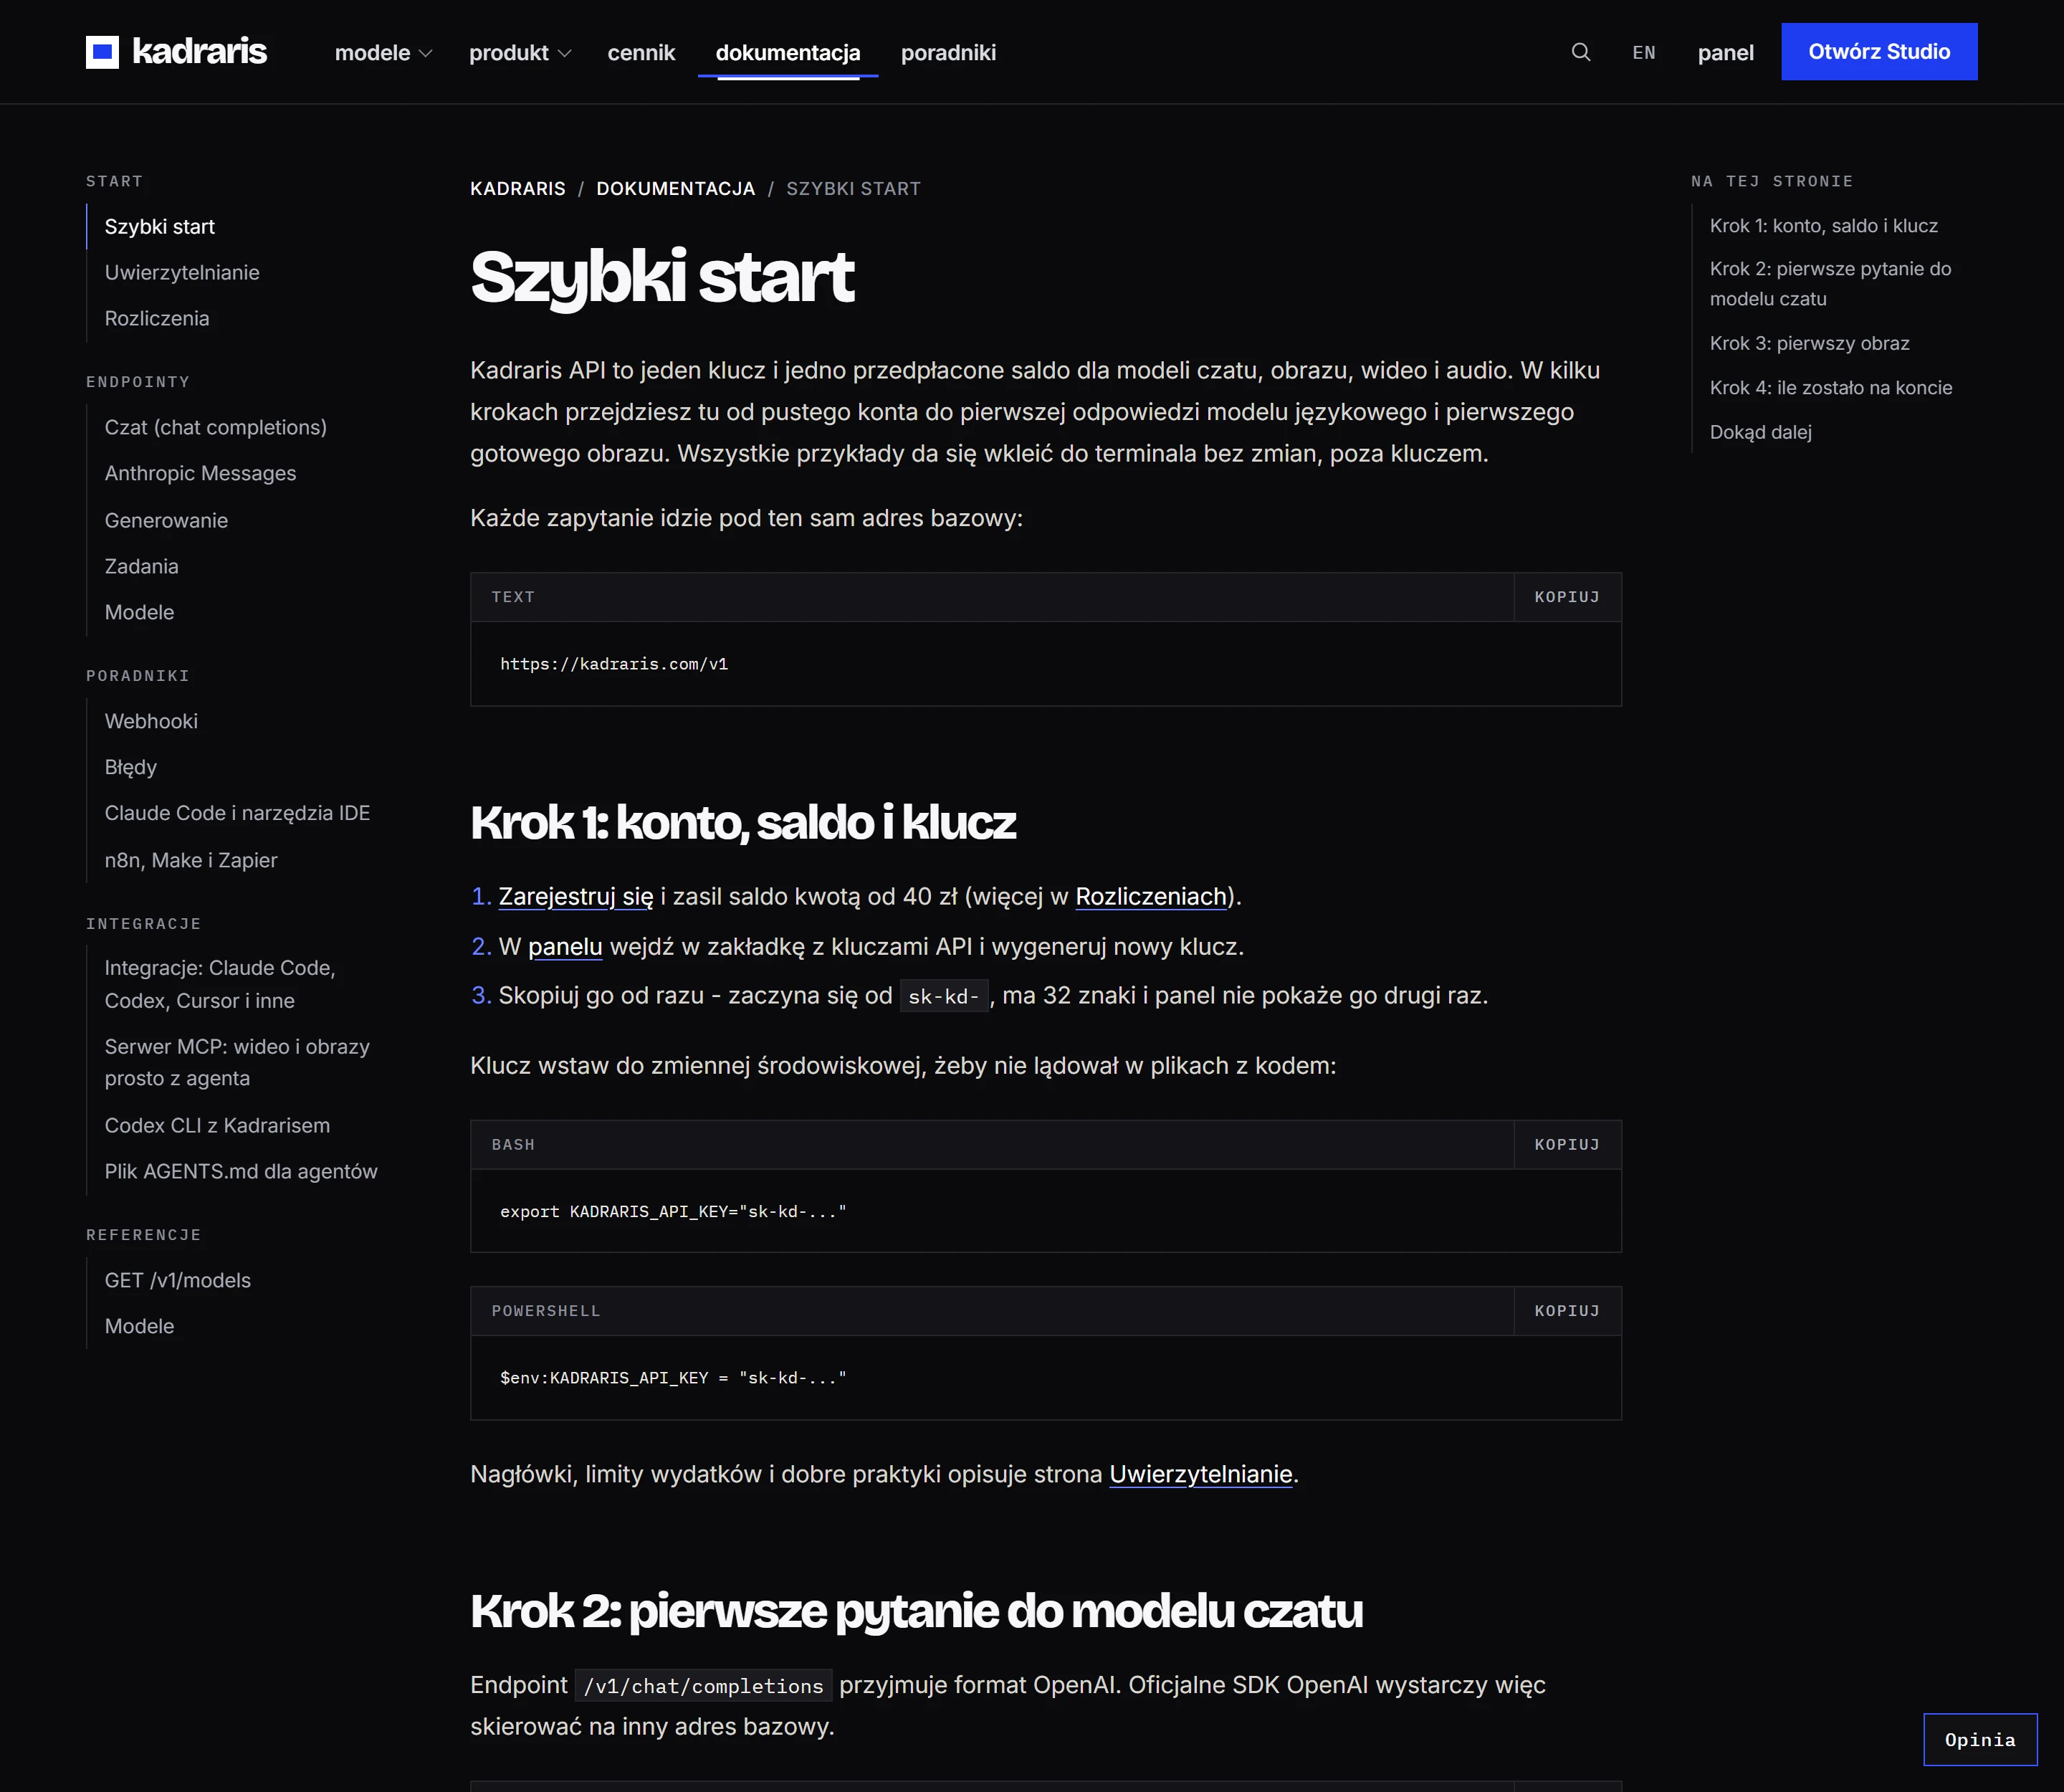
/v1/chat/completions w Kadrarisie jest zgodne z OpenAI. Bierzesz oficjalne SDK i podmieniasz adres oraz klucz.
pip install openai
export KADRARIS_API_KEY=sk-kd-...import os
from openai import OpenAI
client = OpenAI(
base_url="https://kadraris.com/v1",
api_key=os.environ["KADRARIS_API_KEY"],
)
resp = client.chat.completions.create(
model="gpt-6-sol",
messages=[
{"role": "system",
"content": "Odpisuj po polsku, krótko."},
{"role": "user",
"content": "Co może pójść źle przy przejściu "
"z PHP 7.4 na PHP 8.3?"},
],
)
print(resp.choices[0].message.content)
# tokeny wejścia i wyjścia, czyli podstawa rachunku
print(resp.usage)Node.js:
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://kadraris.com/v1",
  apiKey: process.env.KADRARIS_API_KEY,
});

const resp = await client.chat.completions.create({
  model: "gpt-6-luna",
  messages: [{
    role: "user",
    content: "Kategoria dla: 'Nie przyszła paczka'. " +
             "Do wyboru: dostawa, zwrot, płatność.",
  }],
});
console.log(resp.choices[0].message.content);
Sam curl:
curl https://kadraris.com/v1/chat/completions \
  -H "Authorization: Bearer $KADRARIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gpt-6-astra",
       "messages": [{"role": "user",
         "content": "Znajdź słabe punkty tego planu wdrożenia."}]}'
Streaming (stream: true) i narzędzia (tools) działają jak w API OpenAI. Szczegóły w dokumentacji czatu.
Rozliczenie w złotych
Kupując bezpośrednio u OpenAI, płacisz w dolarach kartą, a firma księguje to jako import usług - opisałem to w poradniku faktura VAT za API AI. W Kadrarisie:
- stawki w złotych brutto z 23% VAT, przeliczone po kursie NBP,
- BLIK albo karta, doładowanie od 40 zł,
- faktura VAT na firmę - zaznaczasz ją przy doładowaniu,
- saldo nie wygasa, nie ma abonamentu ani minimalnego zobowiązania,
- ten sam klucz obsłuży Claude, Gemini, DeepSeek oraz modele obrazu i wideo.
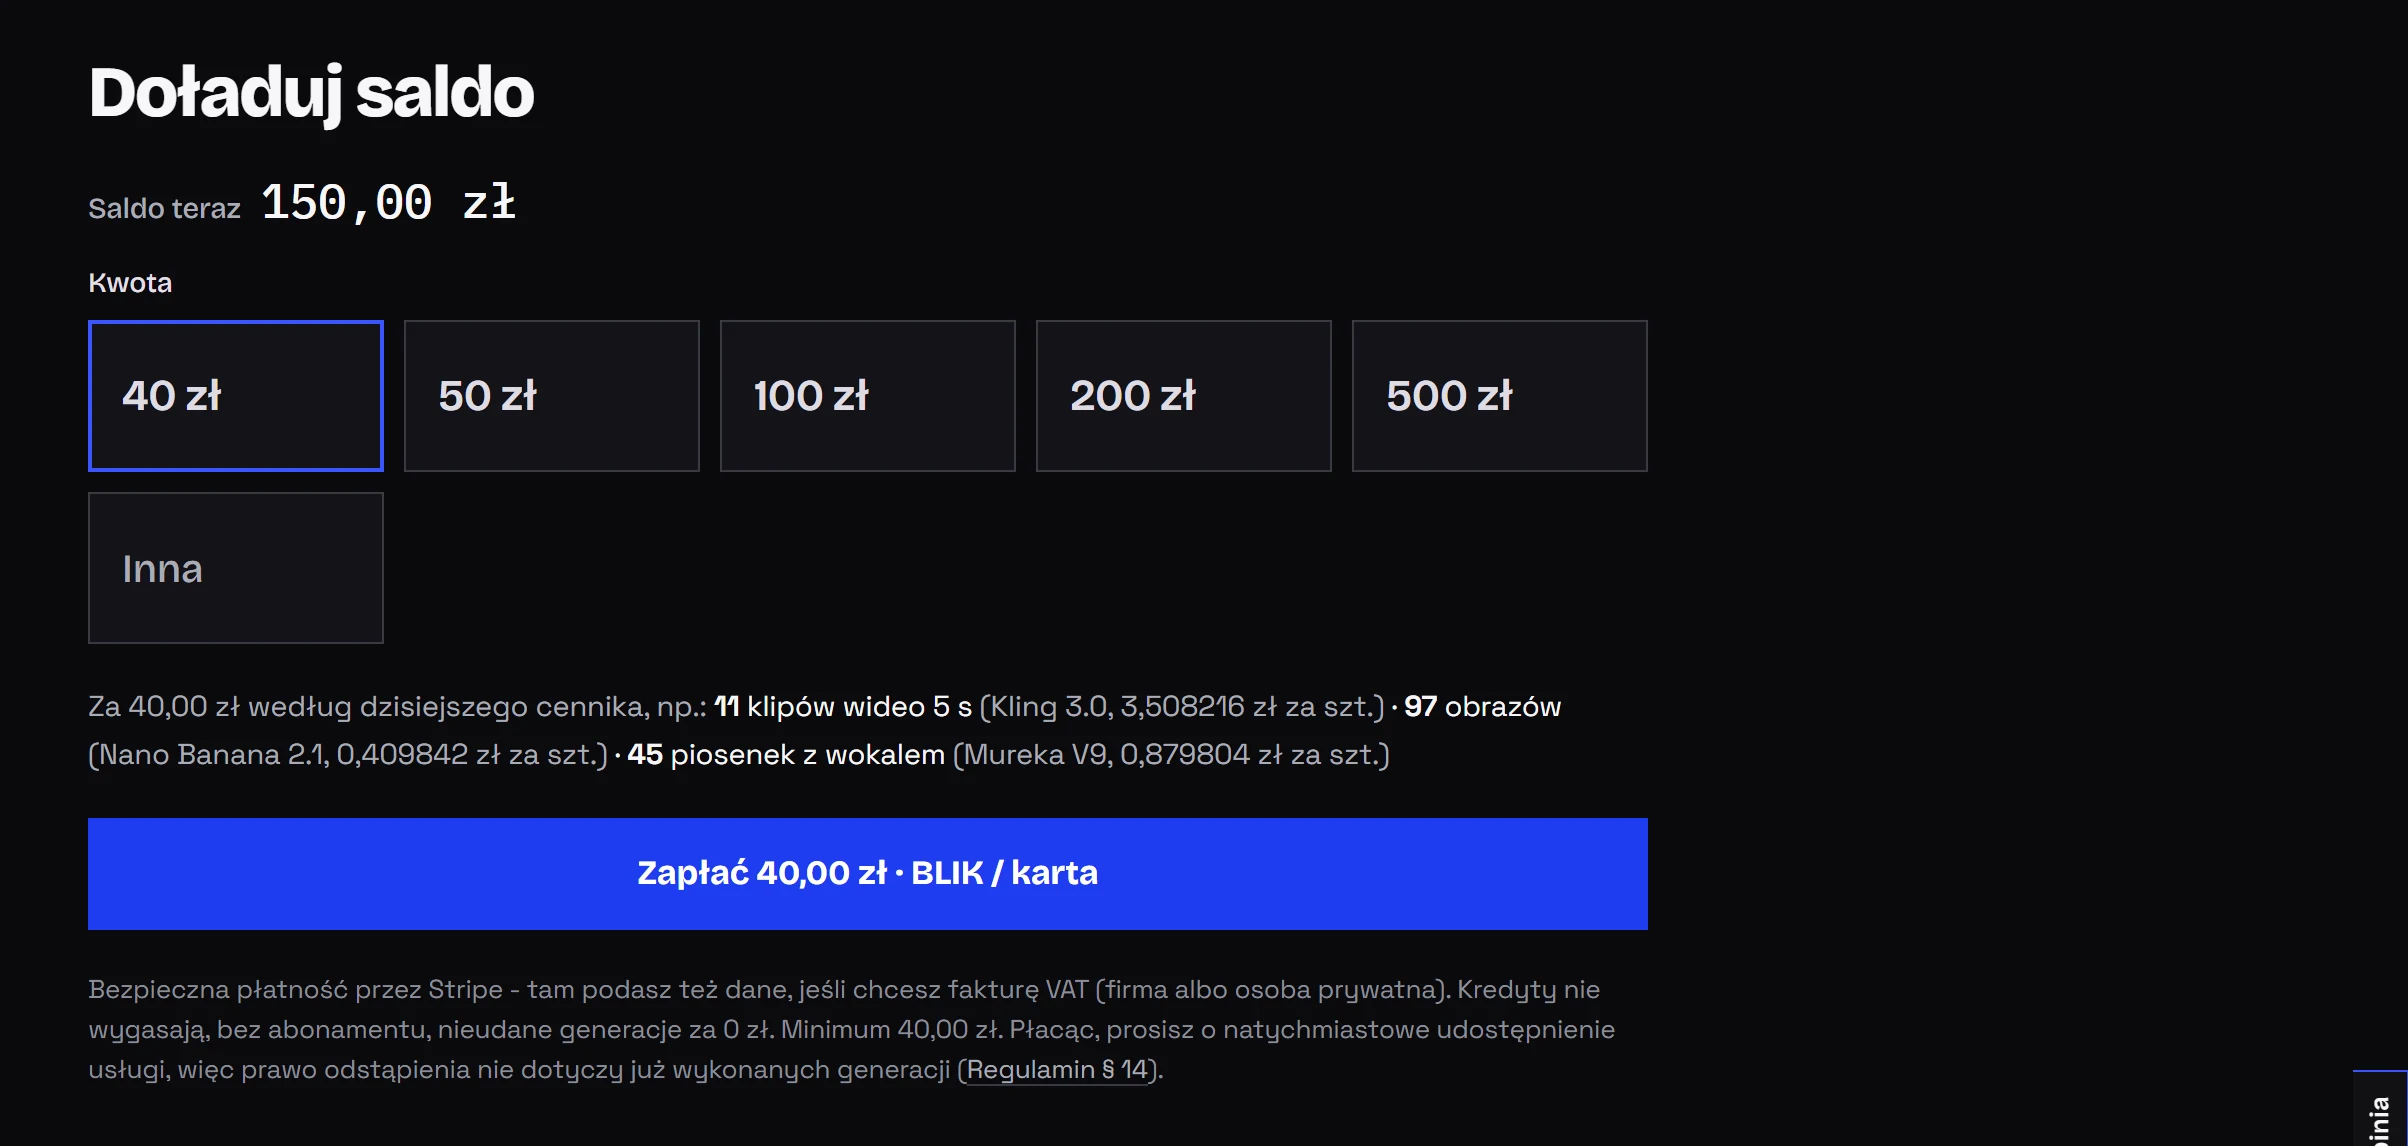
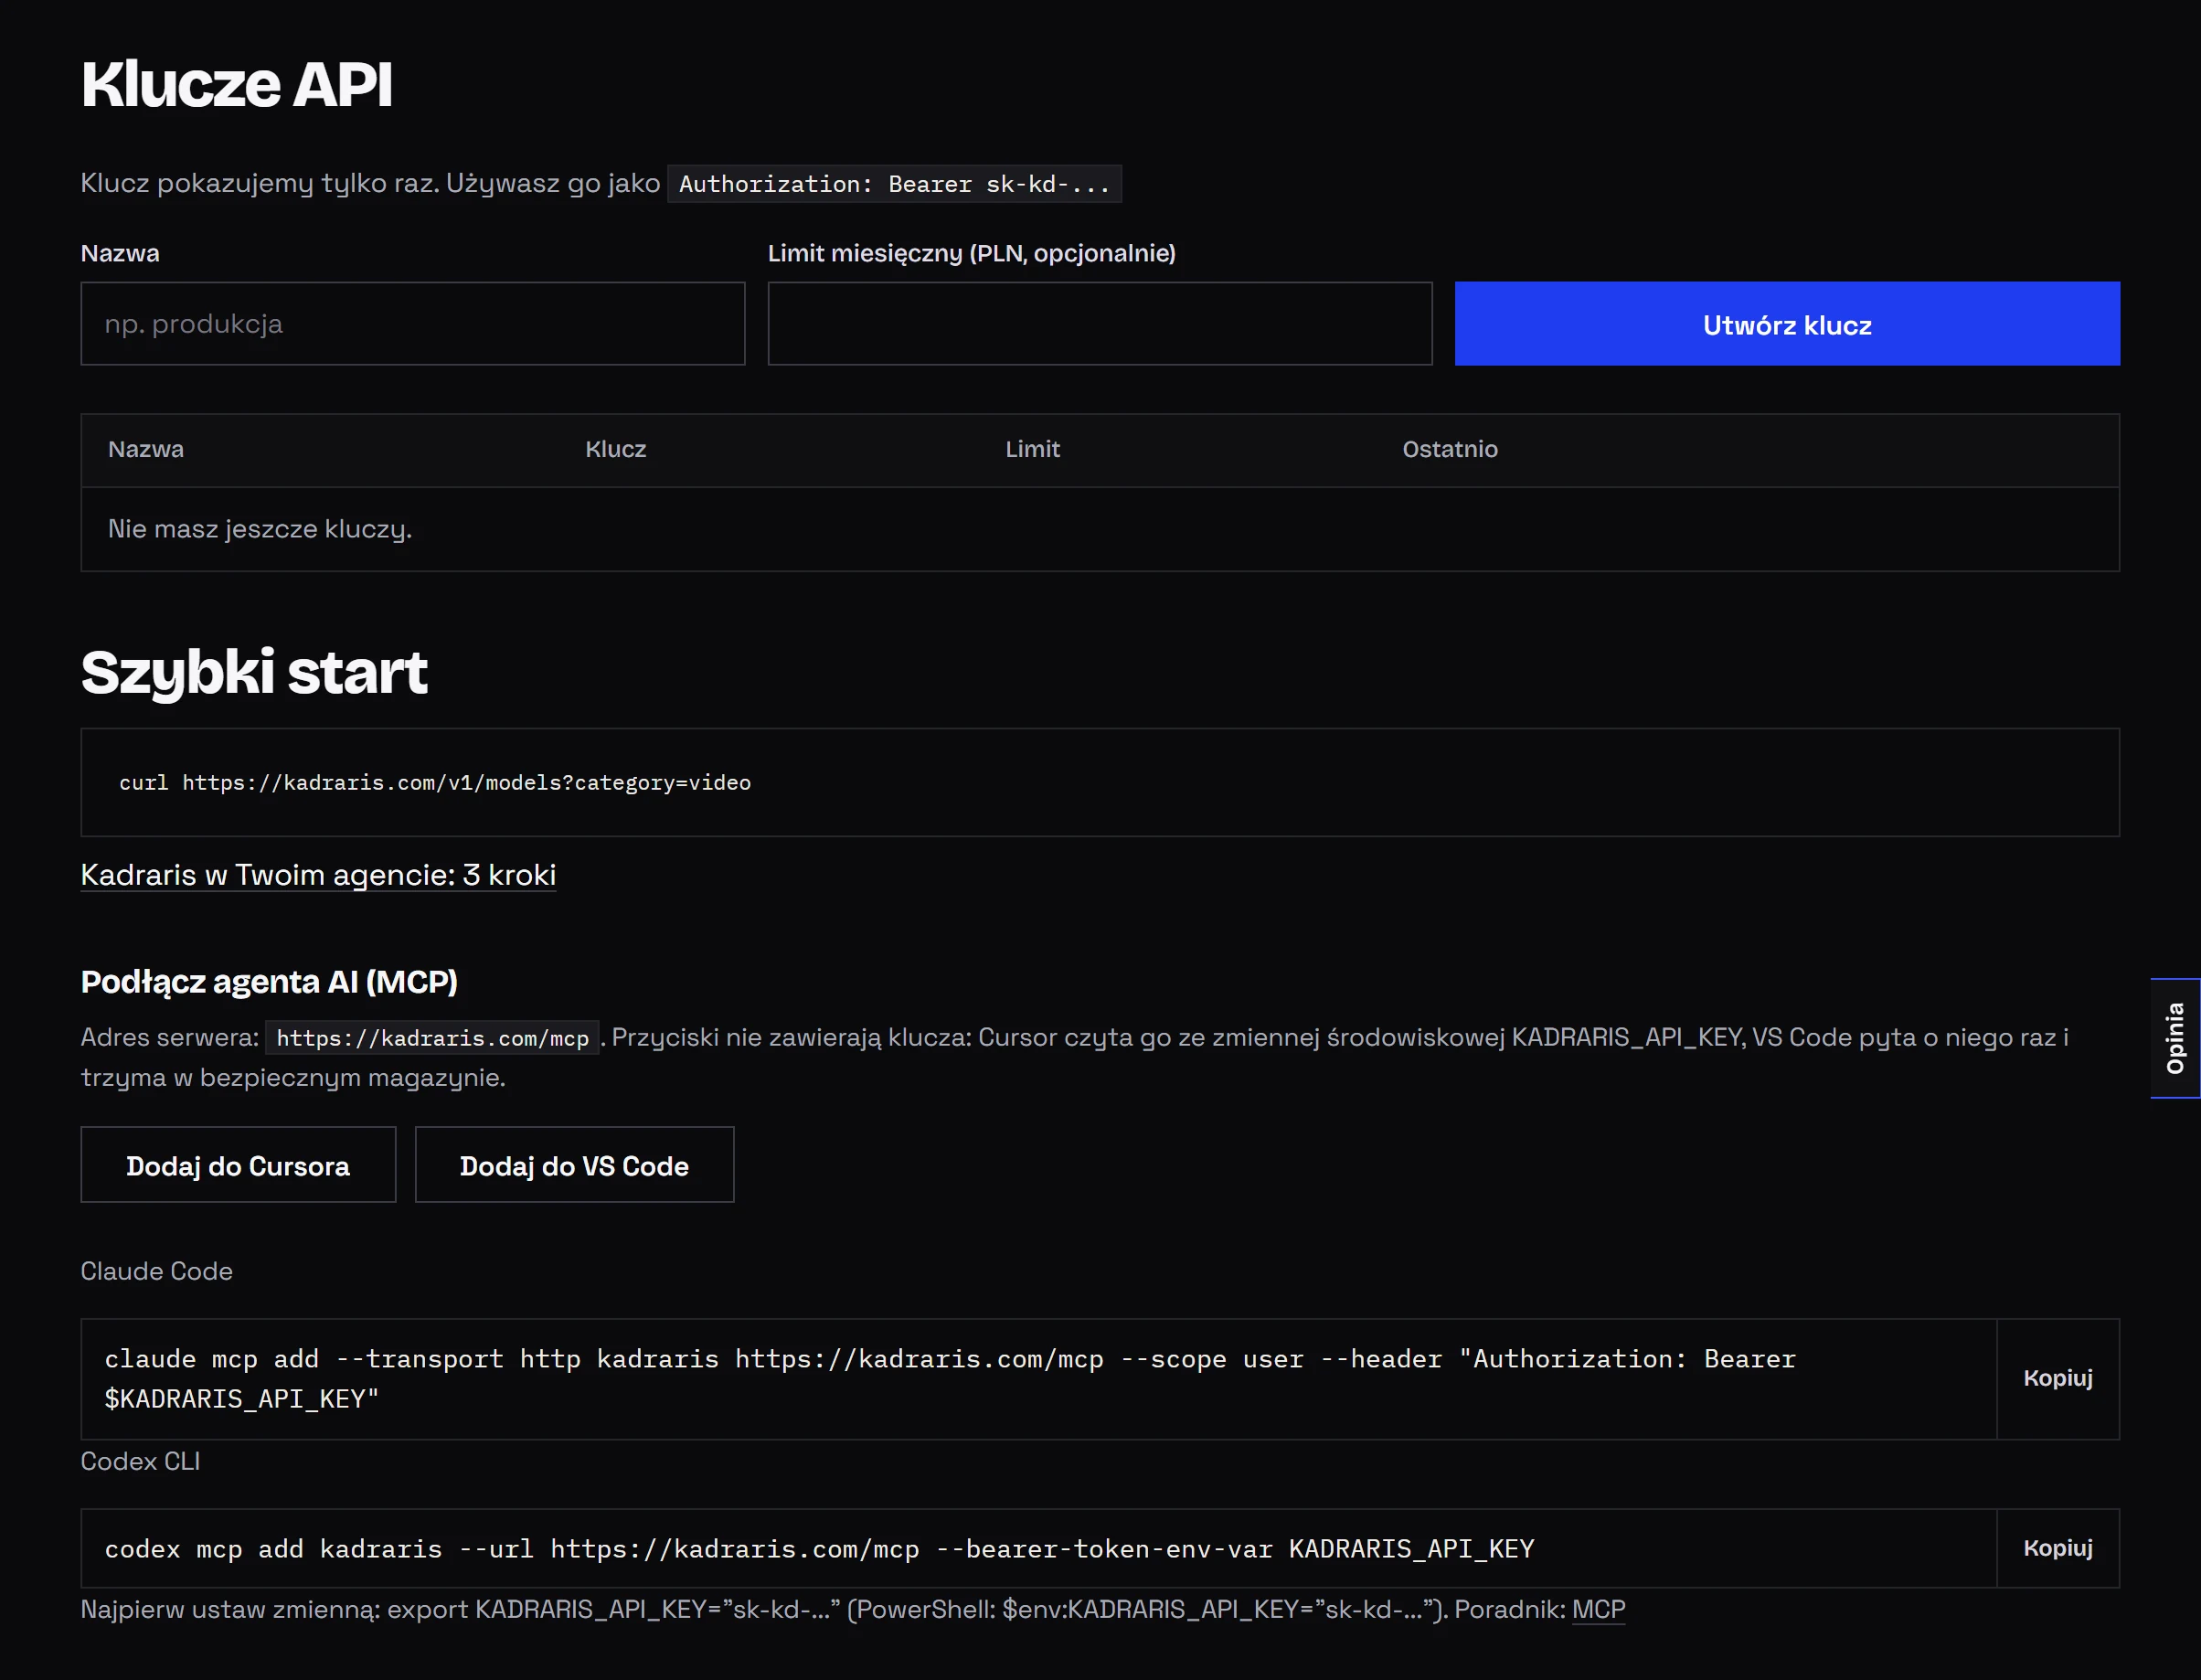
Start: załóż konto, doładuj saldo i w panelu utwórz klucz API. Ustaw przy nim miesięczny limit w złotych - po jego przekroczeniu API odpowiada 403, więc zapętlony skrypt staje na limicie, a nie na zerowym saldzie. Dla Astry zawsze robię osobny klucz z niskim limitem.
Pięć sposobów na niższy rachunek
- Routing według trudności. Większość ruchu obsługuje Luna, Sol dostaje tylko to, czego Luna nie umie. Mapa w kodzie, zmiana modelu to jedna linijka.
- Odchudzony prompt systemowy. Leci z każdym zapytaniem: 2 tys. tokenów instrukcji razy 10 tys. zapytań dziennie to 20 mln tokenów wejścia.
- Limit
max_tokens. Zwłaszcza tam, gdzie odpowiedź ma być krótka. - Skracanie historii. W czacie zostaw ostatnie wiadomości i krótkie podsumowanie starszych.
- Pomiar. Zapisuj
usagez każdej odpowiedzi i licz koszt na prawdziwych danych - szacunki z tabelek rzadko się sprawdzają.
Szukasz najtańszych modeli w ogóle, nie tylko od OpenAI? Porównanie na 1000 odpowiedzi czatu jest w poradniku najtańsze API LLM. O kodowaniu w terminalu piszę w tekście Claude Code - cena i start, a o limitach planu i błędzie 529 w poradniku Claude Code - limity i błędy.
Pytania
Dlaczego krótka odpowiedź Astry kosztowała tyle co długa?
Bo modele GPT-6 rozumują przed odpowiedzią, a tokeny rozumowania są liczone jako wyjście. Widać to w usage.completion_tokens. Jeśli zadanie nie wymaga głębokiego myślenia, przenieś je na Sol albo Lunę.
Mój stary kod zwraca błąd przy Astrze. Co poprawić?
Najczęściej winne są temperature albo top_p - Astra nie przyjmuje własnych wartości tych pól. Usuń je z zapytania i spróbuj ponownie.
Czy płacę za zapytanie, które zakończyło się błędem?
Nie. Nieudane zapytanie nie jest rozliczane, a środki zablokowane na nie wracają na saldo.
Jak zmienić model w istniejącej aplikacji na SDK OpenAI?
Ustaw base_url na https://kadraris.com/v1, klucz na sk-kd-..., a w polu model wpisz gpt-6-sol, gpt-6-luna lub gpt-6-astra. Streaming i narzędzia działają bez zmian w kodzie.