
Cztery rodziny modeli, jeden klucz - GPT, Claude, Gemini i DeepSeek w Pythonie i Node
Jedno API dla GPT, Claude, Gemini i DeepSeeka: model jako zmienna, porównanie odpowiedzi z kosztem w zł, fallback przy błędach, kod Python i Node.
 Piotr Olszewski2026-10-225 minEnglish
Nie potrzebujesz czterech SDK, żeby rozmawiać z GPT, Claude, Gemini i DeepSeekiem. Wystarczy oficjalne SDK OpenAI ustawione na https://kadraris.com/v1 - poradzi sobie z każdym czatowym modelem z oferty, a zmiana modelu to podmiana napisu, np. gpt-6-sol na claude-sonnet-5 czy deepseek-v4-flash. Płacisz z jednego konta w złotych i dostajesz polską fakturę.
W tekście: gotowe skrypty Python i Node, wybór modelu przez konfigurację, równoległy test kilku modeli ze stoperem i wyceną, zapasowy model na wypadek awarii oraz różnice między modelami, które wychodzą dopiero w praktyce.
Po co upraszczać
OpenAI, Anthropic, Google i DeepSeek mają własne biblioteki, własną strukturę wiadomości, własne błędy i własne rozliczenia w dolarach. Integracja z każdym osobno oznacza mnożenie kodu, sekretów i dokumentów dla księgowej.
Kadraris API udostępnia /v1/chat/completions zgodne z OpenAI, które przyjmie dowolny model czatu, oraz /v1/messages zgodne z Anthropic, przeznaczone dla Claude. W kodzie model staje się zwykłą wartością w konfiguracji, w księgowości - jednym saldem w złotych i krajową fakturą.
| Przykładowy model | Identyfikator | Za 1 mln tokenów (wejście / wyjście) |
|---|---|---|
| GPT-6 Sol | gpt-6-sol | 11,73 zł / 58,65 zł za 1 mln tokenów |
| Claude Sonnet 5 | claude-sonnet-5 | 17,60 zł / 87,98 zł za 1 mln tokenów |
| Gemini 3.6 Flash | gemini-3.6-flash | 4,29 zł / 21,45 zł za 1 mln tokenów |
| DeepSeek V4 Flash | deepseek-v4-flash | 0,733 zł / 1,47 zł za 1 mln tokenów |
| GPT-6 Luna | gpt-6-luna | 0,587 zł / 2,93 zł za 1 mln tokenów |
Komplet, łącznie z GLM, Kimi i MiniMax, znajdziesz w katalogu modeli i pod GET /v1/models?category=chat.
Przygotowanie
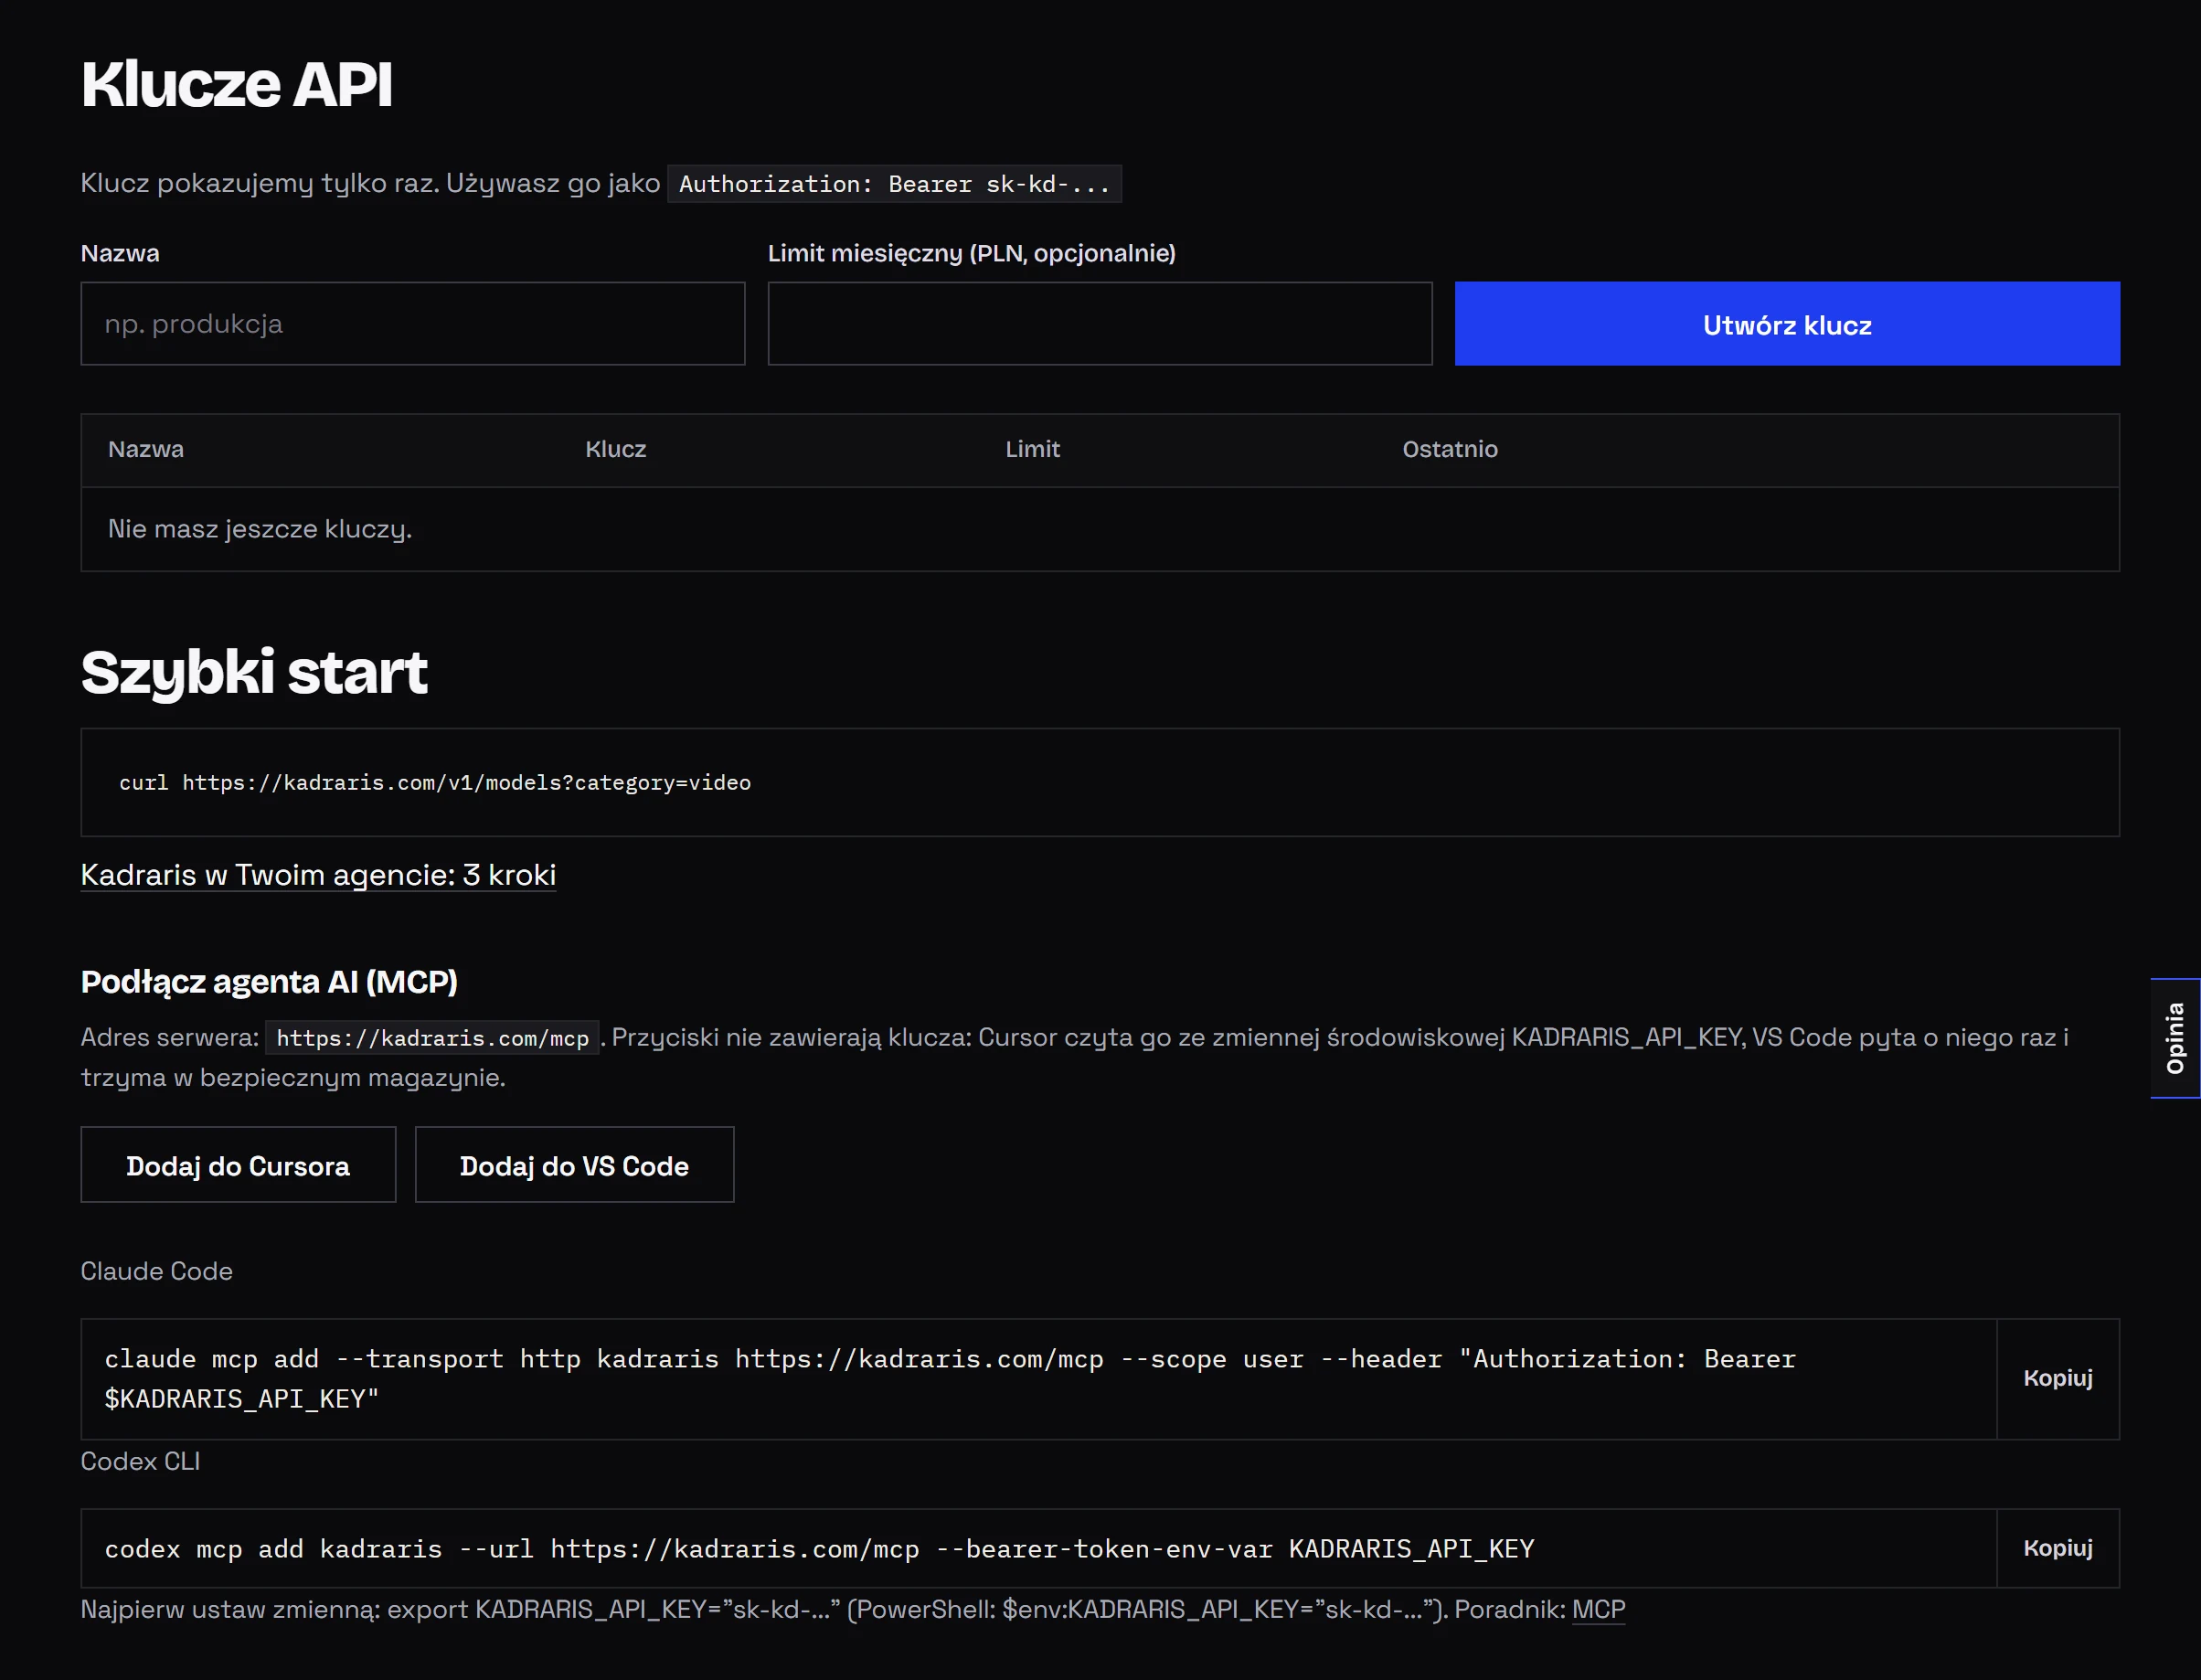
- Zarejestruj się (rejestracja) i zasil konto, choćby minimalnymi 40 zł przez BLIK.
- Wygeneruj klucz w ustawieniach konta i od razu nadaj mu miesięczny pułap wydatków. Klucz
sk-kd-...zobaczysz tylko raz. - Trzymaj go w zmiennej środowiskowej, nie w repozytorium.
pip install openai requests
export KADRARIS_API_KEY=sk-kd-...
export LLM_MODEL=gpt-6-sol
W PowerShellu: $env:KADRARIS_API_KEY = "sk-kd-...".
Model jako zmienna
Najprostszy wariant: model czytasz ze zmiennej środowiskowej i przełączasz go bez dotykania kodu.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://kadraris.com/v1",
    api_key=os.environ["KADRARIS_API_KEY"],
)
MODEL = os.environ.get("LLM_MODEL", "gpt-6-sol")


def ask(prompt, model=MODEL):
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system",
             "content": "Piszesz po polsku, bez lania wody."},
            {"role": "user", "content": prompt},
        ],
    )
    return resp.choices[0].message.content


q = "Kiedy w SQL użyć LEFT JOIN zamiast INNER JOIN?"
print(ask(q))
print(ask(q, model="claude-sonnet-5"))
Wystarczy LLM_MODEL=deepseek-v4-flash python app.py, żeby identyczny skrypt odpowiadał DeepSeekiem. Strumieniowanie (stream=True) i wywołania funkcji (tools) wyglądają tak samo bez względu na model - szczegóły w dokumentacji czatu.
Test kilku modeli z kosztem w złotych
Zanim wybiorę model do projektu, wysyłam te same pytania do kilku modeli jednocześnie i oceniam jakość, czas i koszt. Cennik ściągam z otwartego GET /v1/models (kwoty brutto w złotych), liczbę tokenów odczytuję z usage.
import os
import time
from concurrent.futures import ThreadPoolExecutor

import requests
from openai import OpenAI

BASE = "https://kadraris.com/v1"
client = OpenAI(base_url=BASE,
                api_key=os.environ["KADRARIS_API_KEY"])

catalog = requests.get(
    f"{BASE}/models",
    params={"category": "chat", "currency": "PLN"},
    timeout=30).json()["data"]
PRICES = {m["id"]: m["pricing"] for m in catalog}

MODELS = ["gpt-6-sol", "claude-sonnet-5",
          "gemini-3.6-flash", "deepseek-v4-flash"]
PROMPT = ("Klientka pyta, czy może zwrócić buty noszone "
          "raz. Odpisz grzecznie w 3 zdaniach.")


def run(model):
    start = time.perf_counter()
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": PROMPT}])
    u, p = r.usage, PRICES[model]
    cost = (u.prompt_tokens * float(p["input_per_mtok"])
            + u.completion_tokens
            * float(p["output_per_mtok"])) / 1_000_000
    took = time.perf_counter() - start
    return (model, took, u.prompt_tokens,
            u.completion_tokens, cost,
            r.choices[0].message.content)


with ThreadPoolExecutor(max_workers=len(MODELS)) as pool:
    results = list(pool.map(run, MODELS))

# od najtańszej odpowiedzi
for model, sec, tin, tout, cost, text in sorted(
        results, key=lambda x: x[4]):
    print(f"\n--- {model} | {sec:.1f} s | "
          f"{tin}+{tout} tok. | {cost:.4f} zł")
    print(text)
Co warto wiedzieć, czytając wynik:
- pojedyncze zapytanie to anegdota; wiążącą decyzję podejmuję po 20-50 realnych przypadkach,
- u modeli rozumujących tokeny wyjścia obejmują też myślenie, więc krótka odpowiedź może mieć ich sporo,
- tokenizery się różnią, więc identyczne zdanie kosztuje każdy model inną liczbę tokenów - liczy się cena odpowiedzi, nie stawka z tabeli.
Ranking stawek na przykładzie 1000 odpowiedzi czatu pokazuję w poradniku najtańsze API LLM.
Plan B, gdy model milczy
Awarie u producentów się zdarzają. Niektóre modele w Kadrarisie same przechodzą na innego dostawcę infrastruktury, ale własny mechanizm w aplikacji to dodatkowe zabezpieczenie: lista modeli zapasowych. Uważaj tylko, by nie skakać po modelach, gdy problem leży po twojej stronie.
import time
from openai import APIStatusError, APIConnectionError

CHAIN = ["claude-sonnet-5", "gpt-6-sol",
         "gemini-3.6-flash"]
# klucz, saldo, limit klucza, złe parametry
NO_RETRY = {401, 402, 403, 422}


def ask_with_fallback(messages, **kw):
    last = None
    for model in CHAIN:
        for attempt in range(2):
            try:
                r = client.chat.completions.create(
                    model=model, messages=messages, **kw)
                return model, r.choices[0].message.content
            except APIStatusError as e:
                if e.status_code in NO_RETRY:
                    raise
                last = e
                if e.status_code == 404:
                    break  # brak modelu: od razu kolejny
                # 429 i 5xx: krótka pauza, potem ponowienie
                time.sleep(2 * (attempt + 1))
            except APIConnectionError as e:
                last = e
                time.sleep(2 * (attempt + 1))
    raise last


model, answer = ask_with_fallback(
    [{"role": "user",
      "content": "Wyjaśnij w 5 punktach, czym jest KSeF."}])
print(f"[{model}] {answer}")
Jak traktować poszczególne kody:
| Kod | Co się stało | Zmienić model? |
|---|---|---|
| 401 | zły lub usunięty klucz | nie |
| 402 | za mało środków | nie, doładuj |
| 403 | klucz wyczerpał limit miesięczny | nie, podnieś limit |
| 404 | nie ma takiego modelu | tak, i popraw identyfikator |
| 422 | coś nie tak z polami zapytania | nie, napraw treść |
| 429 | za dużo zapytań naraz | tak, odczekaj |
| 502 | awaria u dostawcy modelu | tak |
Za nieudane wywołanie nic nie płacisz, więc kolejna próba nie dubluje kosztów. Wszystkie kody opisuje dokumentacja błędów.
Wersja dla Node.js
npm install openaiimport OpenAI from "openai";
const BASE = "https://kadraris.com/v1";
const client = new OpenAI({
baseURL: BASE,
apiKey: process.env.KADRARIS_API_KEY,
});
const res = await fetch(
`${BASE}/models?category=chat¤cy=PLN`);
const prices = Object.fromEntries(
(await res.json()).data.map((m) => [m.id, m.pricing]));
const models = ["gpt-6-luna", "claude-haiku-4.5",
"deepseek-v4-flash"];
const prompt = "Wymyśl 3 nazwy dla warsztatu rowerowego.";
const results = await Promise.allSettled(
models.map(async (model) => {
const r = await client.chat.completions.create({
model,
messages: [{ role: "user", content: prompt }],
});
const p = prices[model];
const cost = (r.usage.prompt_tokens
* Number(p.input_per_mtok)
+ r.usage.completion_tokens
* Number(p.output_per_mtok)) / 1e6;
return { model, cost: cost.toFixed(4) + " zł",
text: r.choices[0].message.content };
}),
);
for (const r of results) {
console.log(r.status === "fulfilled"
? r.value : r.reason.message);
}Dzięki Promise.allSettled awaria jednego modelu nie przerywa testu pozostałych. Zwróć uwagę na pisownię: biblioteka JavaScript oczekuje baseURL, pythonowa - base_url.
Kod pod SDK Anthropic zostaw w spokoju
Jeśli twój projekt korzysta już z biblioteki Anthropic (np. bloki tool_use, cache promptów), zostaw go tak, jak jest - /v1/messages przyjmuje natywny format Claude:
import os
from anthropic import Anthropic

claude = Anthropic(base_url="https://kadraris.com",
                   api_key=os.environ["KADRARIS_API_KEY"])
msg = claude.messages.create(
    model="claude-opus-5.5",
    max_tokens=1024,
    messages=[{"role": "user",
               "content": "Zaprojektuj tabele dla "
                          "wypożyczalni hulajnóg."}],
)
print(msg.content[-1].text)
W tym kliencie bazowy adres jest bez /v1, a obsługiwane są wyłącznie modele Claude. Jeśli łączysz w programie modele kilku producentów, wygodniej trzymać się formatu OpenAI. Koszty i cache Claude rozpisałem w poradniku Claude Opus 5.5 przez API - cena.
Na czym potykam się przy zmianie modelu
Wspólny format nie oznacza identycznego zachowania:
temperatureitop_p. Własne wartości tych pól kończą się w Claude Sonnet 5 kodem 400, a GPT-6 Astra (według dokumentacji OpenAI) też ich nie akceptuje. Kod uniwersalny po prostu ich nie wysyła.max_tokensw modelach, które myślą. Rozumowanie wlicza się do tego limitu, więc zbyt mała wartość daje odpowiedź obciętą lub pustą. Lepiej zostawić pole puste albo dać hojny zapas.- Rozmiar okna i odpowiedzi. Gemini 3.6 Flash odpowie najwyżej 8192 tokenami, a Claude Haiku 4.5 zmieści 200 tys. tokenów kontekstu, nie milion. Wartości dla każdego modelu podaje
GET /v1/modelswcontext_windowimax_output_tokens. - Styl. Identyczne instrukcje systemowe dają u różnych modeli inne tempo, długość i ton. Nowy model najpierw testuję na kilkunastu rozmowach, dopiero potem wpuszczam do użytkowników.
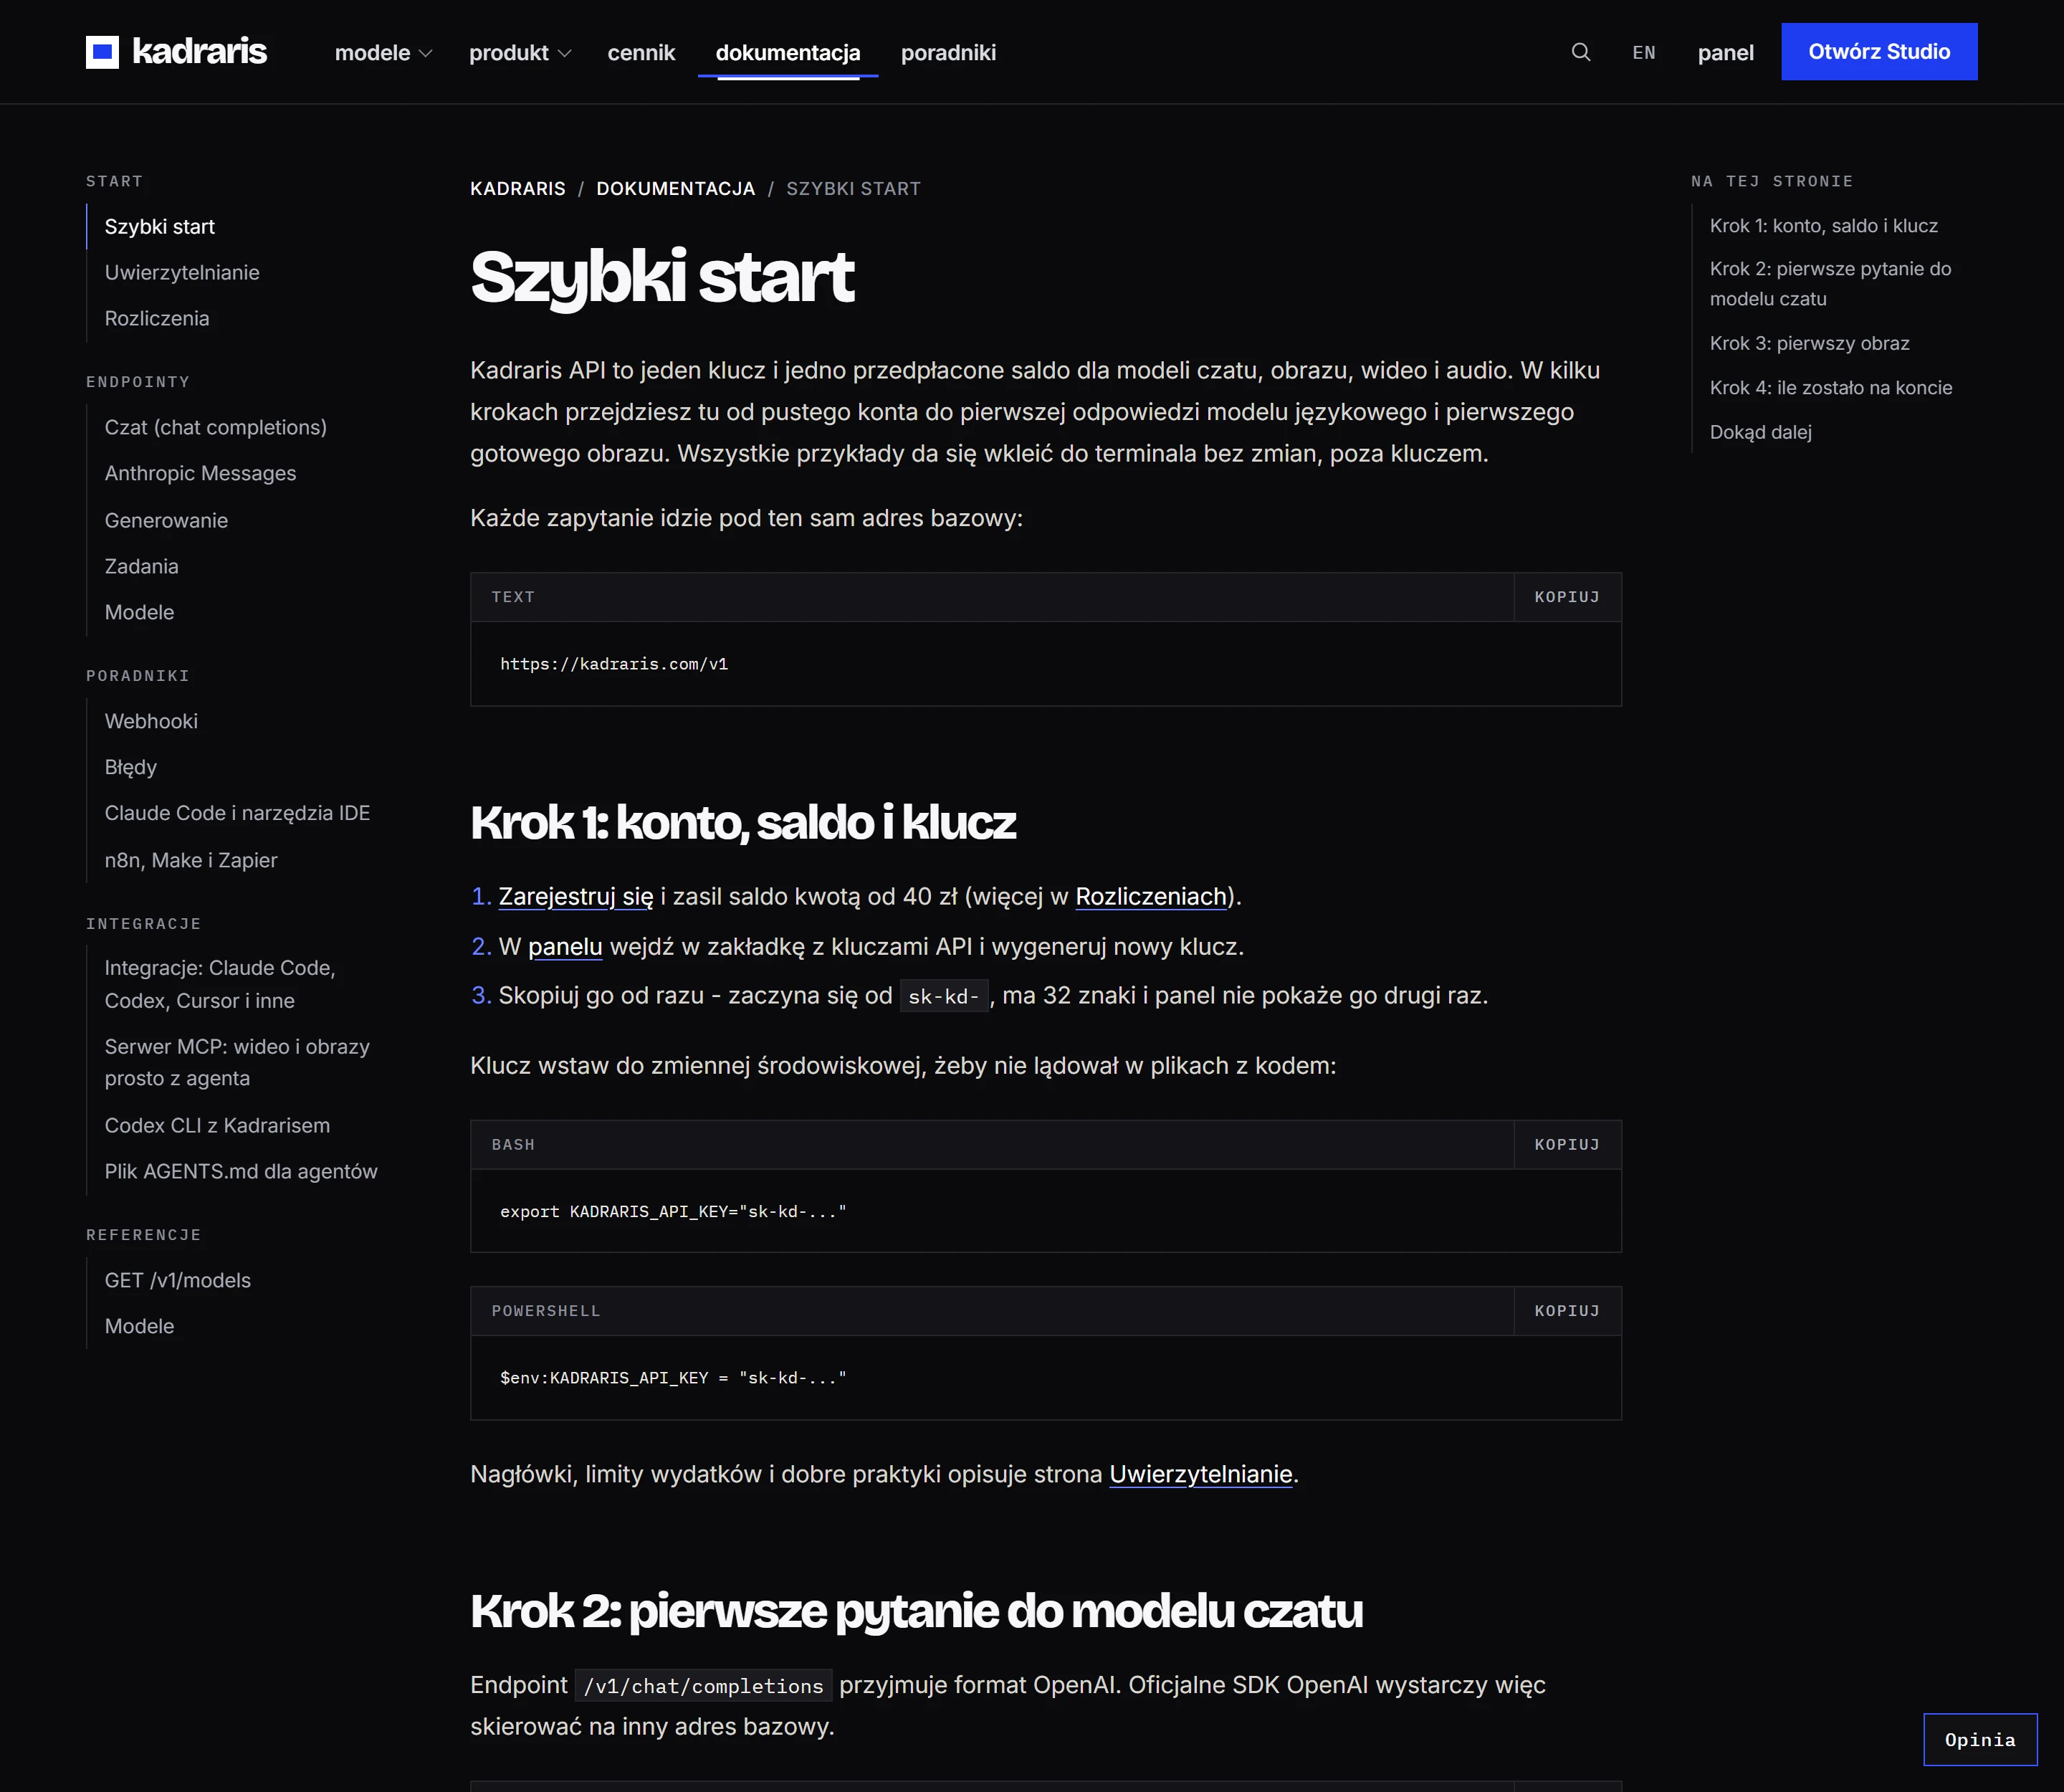
Nie programujesz? Klucz podepniesz też w n8n, Make czy Zapierze z adresem https://kadraris.com/v1; kroki opisuje dokumentacja no-code. Stawki rodziny GPT-6 rozpisałem w poradniku GPT-6 API - cena.
Pytania
Czy przez SDK OpenAI zadziała też Claude?
Tak. Ustaw base_url="https://kadraris.com/v1", klucz sk-kd-... i model claude-sonnet-5. Wszystko idzie w formacie Chat Completions, więc strumieniowanie i funkcje działają jak przy GPT.
Kiedy fallback powinien od razu przerwać, zamiast próbować dalej?
Przy 401, 402, 403 i 422 - wtedy zawodzi klucz, brakuje środków, wyczerpał się pułap albo zapytanie jest źle zbudowane, a zmiana modelu nic nie da. Przełączaj się przy 429, 5xx i błędach połączenia.
Skąd skrypt bierze ceny do wyliczenia kosztu?
Z publicznego GET /v1/models?category=chat¤cy=PLN, który zwraca stawki w złotych z VAT. Zużycie tokenów pochodzi z pola usage każdej odpowiedzi.
Czy jeden klucz obsłuży też modele wideo i obrazu?
Tak. Klucz i saldo działają we wszystkich modelach z katalogu - czacie, obrazach, wideo i muzyce. Fakturę VAT zaznaczasz przy doładowaniu.