
Polska mowa w wideo AI - test łamańca na dziesięciu modelach
Wideo AI po polsku: które modele mówią polską kwestię czysto, a które gubią słowa. Wyniki mojego testu, wzór promptu, koszt klipu i rola lektora.
 Piotr Olszewski2026-10-227 minEnglish
Postać, która mówi po polsku w klipie wygenerowanym za jednym razem, to dziś realna rzecz, ale nie w każdym modelu. 28 września 2026 dałem kilku modelom trudne polskie zdanie. Zero pomyłek miały trzy modele: H3 Max od MiniMaxa, Grok Imagine Video 1.5 oraz Gemini Omni Flash 1.1. Veo 3.1 był blisko ideału. Po jednej wpadce zaliczyły zwykły MiniMax H3 i FLUX.3 Video, a Kling 3.0 Pro zepsuł aż dziesięć wyrazów z dwunastu. W Kadrarisie najłatwiej zacząć od MiniMax H3 (od 0,928 zł za sekundę, stereo zawsze w cenie). Poniżej cała tabela wyników, sposób zapisu polskiej kwestii w prompcie, koszt klipu i sytuacje, w których lepiej nagrać lektora osobno.
Jak wyglądał test
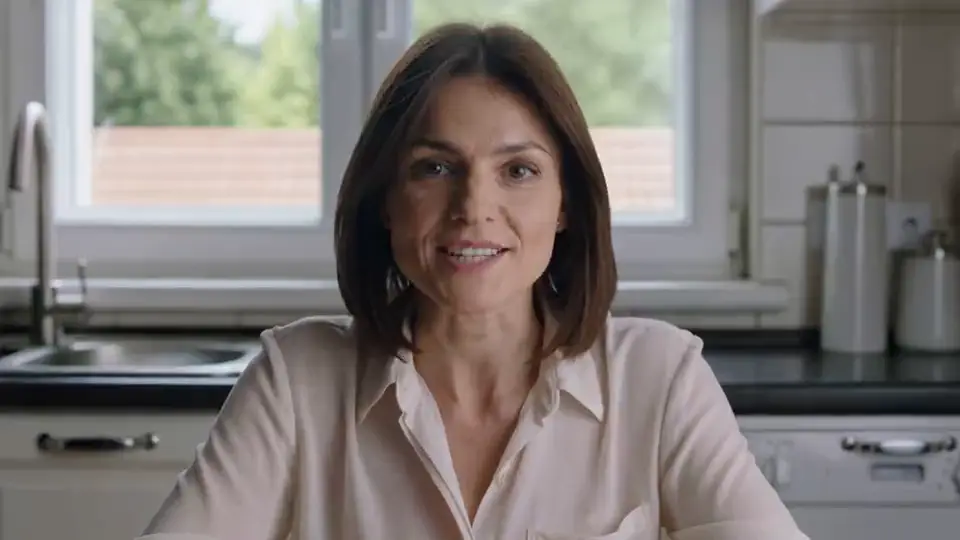
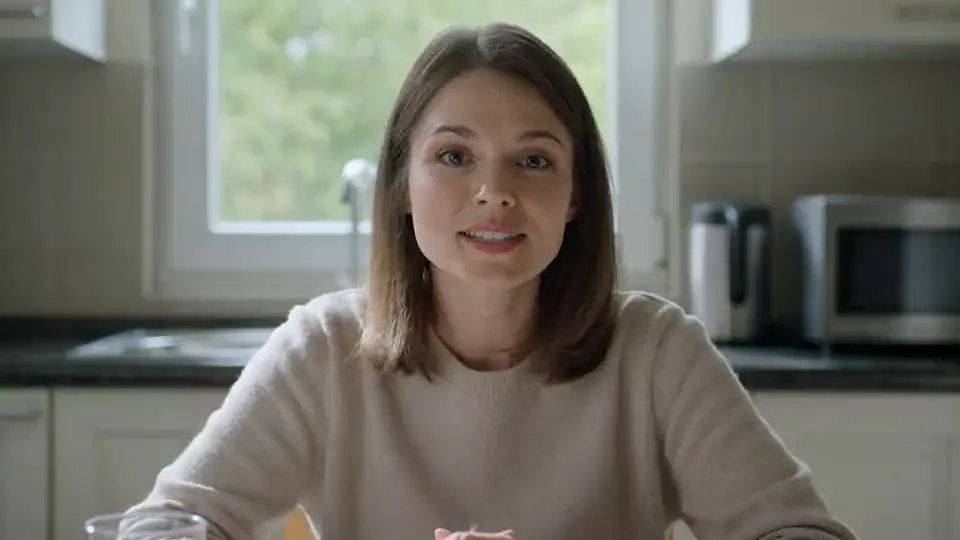
Każdy model dostał identyczną scenę: kobieta siedzi w kuchni, patrzy prosto w kamerę i wypowiada klasyczny łamaniec o chrząszczu ze Szczebrzeszyna, uzupełniony o kwotę "trzydzieści dwa złote". Nagromadzenie spółgłosek, nosówki, "ł" i liczebnik bezlitośnie obnażają słabą wymowę. Ustawienia: 5 sekund, 16:9, 720p (albo najbliższa rozdzielczość danego modelu), dźwięk włączony, jedna próba, bez losowania ponownie.
Każde nagranie trafiło do transkrypcji faster-whisper, osobno w wariancie large-v3 i medium, a ja zliczałem wyrazy, które program zapisał inaczej niż w scenariuszu. Test robiłem przez API, poza Studio, więc wyniki traktuj jako wskazówkę o modelu, a nie gwarancję. Szczegóły opisałem na blogu Promptowy: zestawienie generatorów filmów i osobna próba z Klingiem.
| Model | Złe słowa (large-v3 / medium) | Dźwięk w Kadrarisie |
|---|---|---|
| MiniMax H3 Max | 0 / 0 z 12 | opis w katalogu nie wspomina o audio |
| Grok Imagine Video 1.5 | 0 / 0 | w cenie, ale tylko ze zdjęcia startowego |
| Gemini Omni 1.1 (Flash) | 0 / 0 | opis nie wspomina o dźwięku |
| Veo 3.1 (Quality) | 0 / 2 (pierwsze słowo) | formularz bez przełącznika audio |
| FLUX 3 Video | 1 / 0 | włączony domyślnie |
| MiniMax H3 | 1 / 3 | stereo w każdym klipie |
| Wan 3.0 | 2 / 2 | włączony domyślnie |
| Kling 3.0 Turbo | 4 / 7 | w Kadrarisie bez dźwięku |
| Seedance 2.5 (i 2.0) | 7 / 6-8 | mowa w cenie |
| Kling 3.0 Pro, osobny test | 10 z 12 | 1080p z generate_audio |
Co biorę z tych wyników:
- Na start MiniMax H3. Potknął się wyłącznie na pierwszym wyrazie ("Szczepzeszynie"), resztę powiedział poprawnie, a ścieżka audio jest wliczona w stawkę.
- Grok Imagine Video 1.5 i FLUX.3 Video również wymawiały polszczyznę przyzwoicie. Groka w Kadrarisie uruchomisz tylko ze zdjęciem na start.
- H3 Max wygrał, ale z zastrzeżeniem. W serwisie, w którym go testowałem, był opisany inaczej niż w katalogu Kadrarisa, a nasz opis nie wymienia ścieżki audio. Zanim zamówisz więcej, sprawdź jeden klip.
- Veo 3.1 nie ma w Studio przełącznika dźwięku, dlatego jego dobrego wyniku nie przenoszę wprost na nasz formularz.
- Kling i Seedance zostawiam do obrazu. Wizualnie są mocne, za to polszczyzna w ich wykonaniu jest nieczytelna.
Przy okazji zrobiłem też krótki test w trzech językach. U Klinga polszczyzna i niemiecki brzmiały po amerykańsku, u MiniMaxa H3 angielski i niemiecki miały słyszalnie polską melodię. Można by pomyśleć, że każdy model ma swój "rodzimy" akcent - traktuj to jednak jako moje wrażenie z dwóch nagrań, a nie prawidłowość.
Wzór polskiej kwestii
Opis kadru zostawiam w angielskim, wypowiedź wpisuję po polsku w cudzysłowie i wyraźnie zaznaczam język:
Medium close-up of a man in his forties at a workshop bench, looking into the camera.
He says clearly and calmly in Polish: "Dzień dobry, dziś pokażę, jak wymienić uszczelkę w kranie."
Static camera, natural daylight, quiet workshop ambience, no music, no subtitles, no on-screen text.
Co pomaga przy polskiej mowie:
- Liczby słowami. Napisz "trzydzieści dwa złote", a nie "32 zł", bo inaczej model zgaduje odmianę.
- Jedno zdanie na 4-5 sekund. Dwanaście słów zmieściło się w tym czasie u wszystkich, a przy dłuższej kwestii postać zaczyna trajkotać.
- Prostsze słowa w prawdziwych klipach. Szczebrzeszyn był sprawdzianem. W reklamie wybierz łatwiejsze wyrazy, jeśli możesz.
- "no subtitles" na końcu. Inaczej kwestia potrafi pojawić się jako tekst na obrazie, a podpisy wolę nałożyć sam.
- Charakterystyka głosu. Np. "warm female voice" lub "low calm male voice" plus wiek i tempo mówienia. Bez tego barwa jest loterią.
Kontrolę robię tą samą metodą co w teście: transkrypcja (faster-whisper lub autonapisy CapCuta) i zestawienie ze scenariuszem. Program wyłapie przekręcone słowo, które ucho przepuści.
Zlecenie klipu
Bez kodu: otwórz Kadraris Studio, w kategorii Wideo kliknij MiniMax H3, wklej opis i generuj próby w 768P, a wersję końcową w 2K. Przez API zlecenie wygląda tak:
curl https://kadraris.com/v1/generate \
  -H "Authorization: Bearer $KADRARIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-h3",
    "input": {
      "prompt": "Medium close-up of a man in his forties at a workshop bench, looking into the camera. He says clearly and calmly in Polish: \"Dzień dobry, dziś pokażę, jak wymienić uszczelkę w kranie.\" Static camera, natural daylight, quiet workshop ambience, no music, no subtitles.",
      "aspect_ratio": "16:9",
      "resolution": "768P",
      "duration": 6
    }
  }'
Gdy H3 generuje z samego tekstu, musisz podać konkretne proporcje (adaptive zostanie odrzucone). Jeśli startujesz od zdjęcia osoby, wstawiasz je w image_url, a proporcje model weźmie z obrazu. Plik odbierasz przez GET /v1/tasks/{id}. Jakość obrazu H3 w 2K widać na moim klipie z sierpnia:
Koszt klipu z mową
Rachunek to długość klipu pomnożona przez stawkę i przez liczbę prób. Przy kwestiach mówionych zakładam dwie-trzy próby, bo i najlepszym modelom zdarza się zgubić wyraz:
| Model | Długość | Jedna próba | Trzy próby |
|---|---|---|---|
| MiniMax H3, 768P | 6 s | 6 × od 0,928 zł za sekundę | 18 × od 0,928 zł za sekundę |
| FLUX 3 Video, 720p | 5 s | 5 × od 1,98 zł za sekundę | 15 × od 1,98 zł za sekundę |
| Grok Imagine Video 1.5, 480p | 6 s | 6 × od 0,507 zł za sekundę | 18 × od 0,507 zł za sekundę |
| Wan 3.0, 480P | 5 s | 5 × od 0,448 zł za sekundę | 15 × od 0,448 zł za sekundę |
Stawki dotyczą najniższej rozdzielczości, H3 w 2K jest droższy. Zadanie zakończone błędem kosztuje 0 zł. Minimalna wpłata to 40 zł (karta lub BLIK), fakturę VAT wybierasz w formularzu doładowania. Inne zestawy policzysz w kalkulatorze kosztów.
Kiedy lektor nagrany osobno jest lepszy
Wygenerowany głos zostawiam tylko wtedy, gdy mówi ktoś widoczny na ekranie i mówi krótko. W pozostałych przypadkach wybieram osobny głos:
- Głos zza kadru. Tutorial, spot z komentarzem, prezentacja produktu. Generuję sam obraz (np. Kling 3.0 w 720p z wyłączonym audio, od 0,545 zł za sekundę), a narrację nagrywam lub syntetyzuję osobno i dokładam na osi. Ruch ust wtedy nie gra roli.
- Długa wypowiedź. Sześćdziesiąt sekund mówienia wymaga kilku klipów, a w każdym barwa może wyjść inna. Pojedynczy lektor zapewnia jednolite brzmienie.
- Marki i żargon. Generator może je przeinaczać przy każdej próbie, a nagrany przez ciebie plik jest poprawny raz na zawsze.
Dźwięk nagrany smartfonem dobrze jest oczyścić, np. narzędziem Voice Cleaner, o którym piszę w poradniku o odszumianiu nagrania AI. Do animowania postaci pod gotowe nagranie służy Wan 2.7 Video, który bierze fotografię i plik dźwiękowy jednocześnie (image_url + audio_url). Dokładności ruchu warg w nim nie badałem.
Modele pod kątem mowy porównałem też w zestawieniach MiniMax H3 i Kling 3.0 oraz Kling 3.0 i Veo 3.1, a ożywianie portretów opisuję w poradniku o gadającym zdjęciu AI. Z mowy w reklamach korzystam w reklamach UGC z awatarem.
Pytania
Dlaczego Kling tak słabo mówi po polsku, skoro obraz robi świetny?
Producent nie wymienia polskiego wśród języków obsługiwanych przez Kling 3.0, więc model wymawia nasze słowa po swojemu. Wariant Pro poprawnie powiedział u mnie tylko dwa wyrazy z dwunastu. Po angielsku Kling radzi sobie dobrze.
Czy mogę mieć polską mowę i obraz z Klinga w jednym filmie?
Tak, ale w dwóch krokach. Wygeneruj obraz w Klingu bez dźwięku, a polski głos nagraj albo zsyntetyzuj osobno i połącz w montażu. Synchronizacja ust nie będzie wtedy idealna, więc to rozwiązanie dla narratora spoza kadru.
Jak sprawdzić, czy model nie zjadł końcówki słowa?
Zrób transkrypcję audio (faster-whisper albo autonapisy w CapCut) i porównaj ją słowo po słowie ze scenariuszem. Transkrypcja wyłapie błędy, które przy słuchaniu łatwo przeoczyć.
Ile prób zaplanować na jedną polską kwestię?
Dwie albo trzy. Nawet model, który w teście wypadł dobrze, raz na jakiś czas pomyli słowo, a każda udana próba jest płatna. Nieudane zadania kosztują 0 zł.