
Jeden bohater w całej serii - twarz postaci, która nie odpływa między ujęciami
Spójna postać AI w praktyce: arkusz postaci, referencje w image_urls, pierwsza klatka do wideo, stały opis i rola seeda. Limity modeli i moje testy.
 Piotr Olszewski2026-10-228 minEnglish
Robisz serię rolek z jednym bohaterem i w trzecim ujęciu nagle masz innego człowieka. To nie błąd, tylko sposób działania generatorów. Twarz utrzymasz dzięki obrazowi, a nie dzięki dłuższemu opisowi: raz robisz portret wzorcowy i potem dajesz go modelowi jako referencję w image_urls (przy obrazach) albo jako pierwszą klatkę w image_url (przy wideo). Sam tekst, nawet bardzo szczegółowy, da ci co najwyżej kogoś podobnego. W moim teście dziesięciu modeli okulary i sweter zostawały na miejscu, a twarz się zmieniała. Niżej opisuję, skąd bierze się ten dryf, jak ułożyć pracę, jakie są limity referencji w Kadrarisie i na co nie licz nawet przy najlepszym modelu.
Skąd się bierze inna twarz
Generator nie pamięta, co narysował wcześniej. Każdy obraz startuje z losowego szumu (seed), a tekst jedynie ogranicza pole, na którym ten szum się układa. Wszystko, czego tekst nie określa, model dobiera od zera.
Pokazuje to próba, którą zrobiłem u siebie na Z-Image Turbo: jeden prompt i trzy różne seedy.
portrait of a fisherman in a yellow raincoat on a pier, overcast light, 85mm lens, realistic skin texture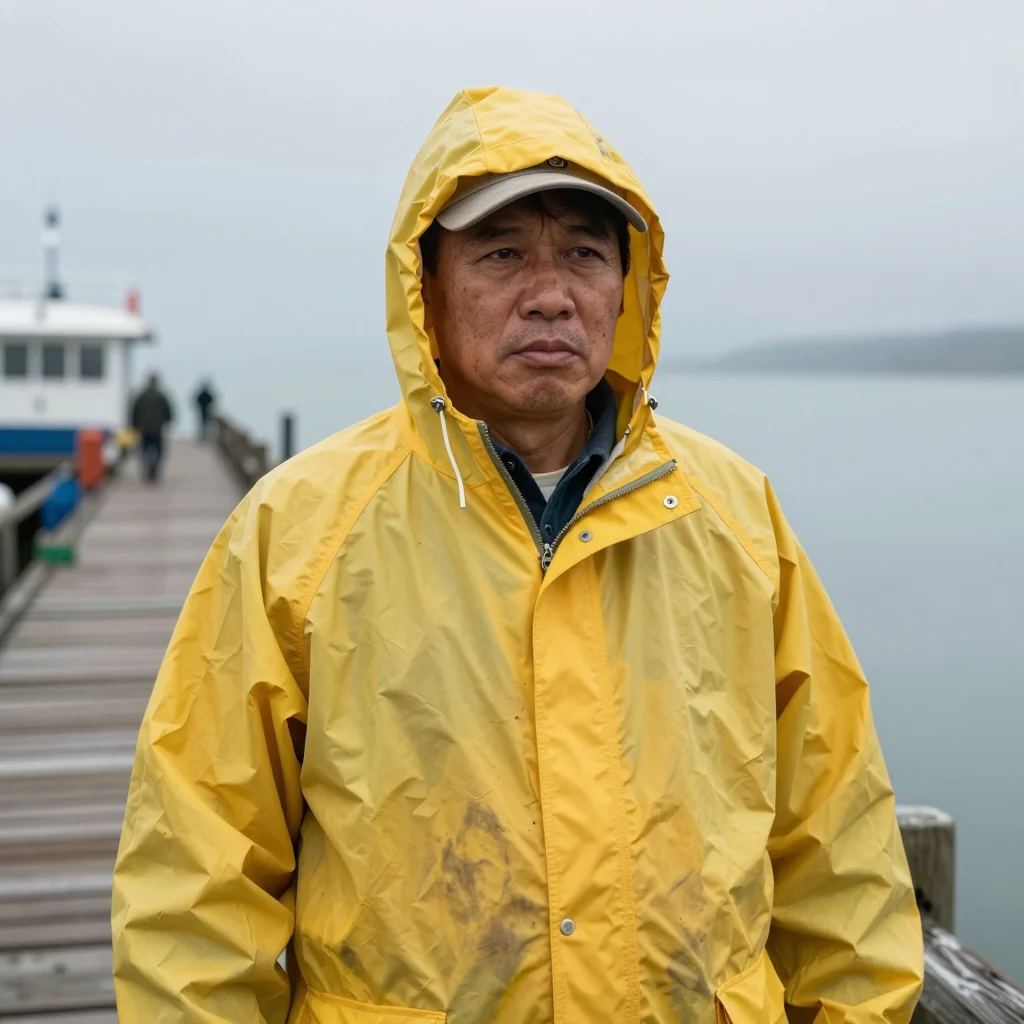
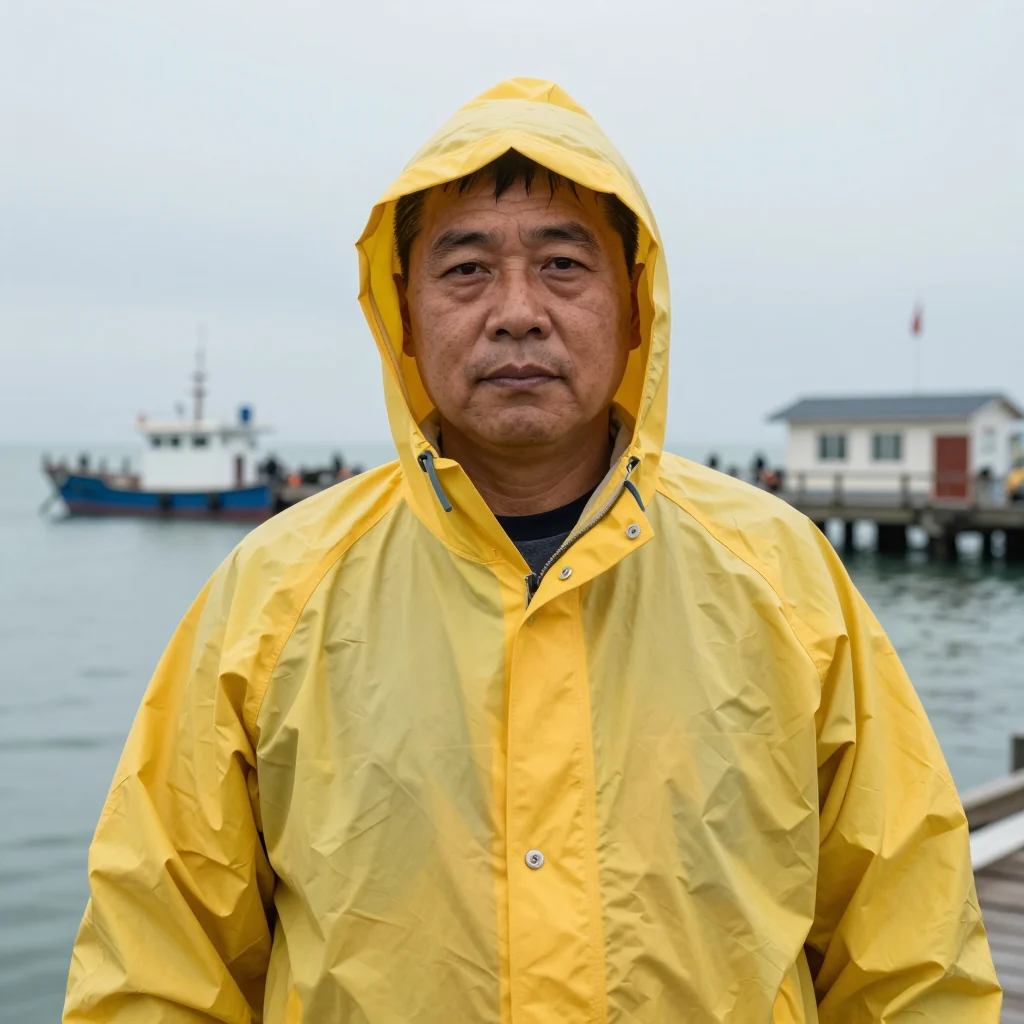
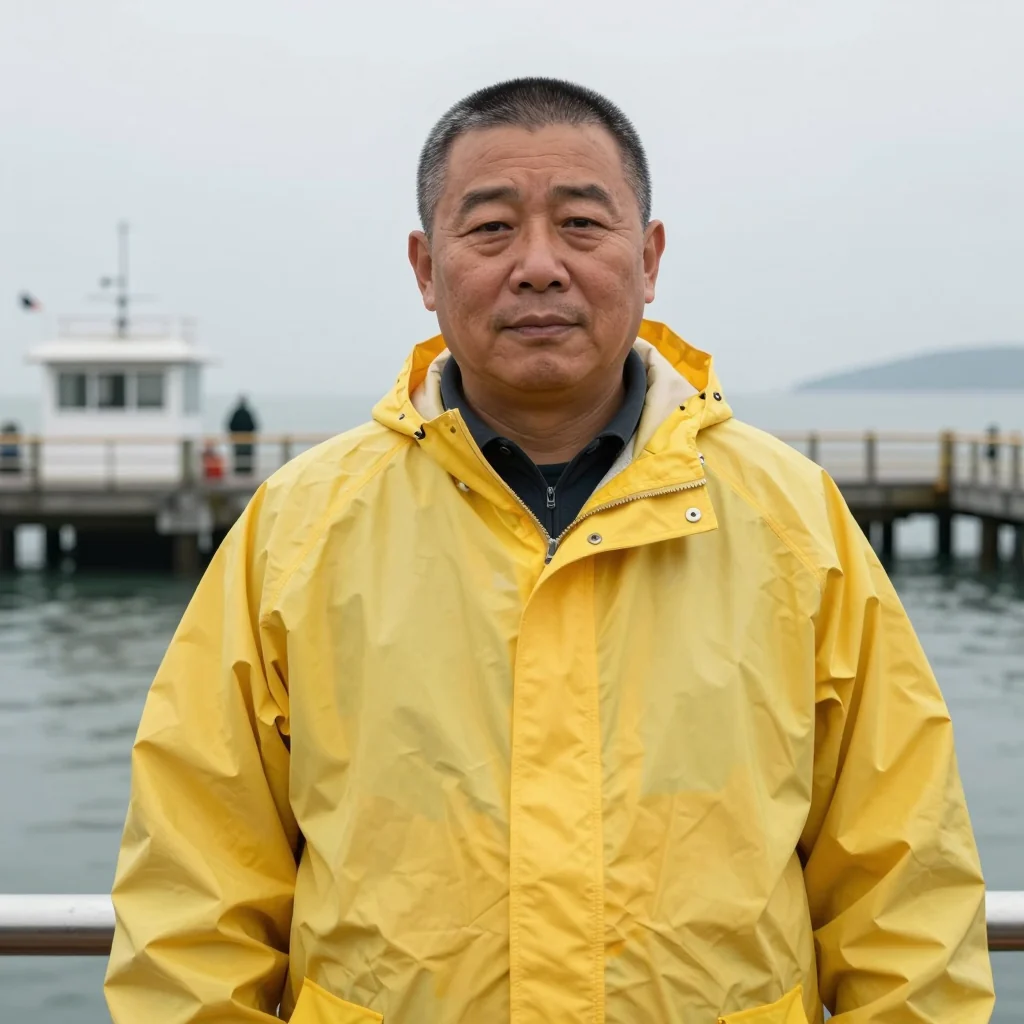
Każdy obraz zgadza się z opisem: żółty płaszcz, pomost, chmury. Tyle że to trzech różnych ludzi, z innym kształtem twarzy, wiekiem i fryzurą. Prompt nic nie mówił o wyglądzie, więc model za każdym razem wymyślał go sam. Opis ustala kategorię, a konkretną osobę generator losuje.
Dziesięć modeli, jeden Marek
W czerwcu 2026 sprawdziłem na promptowy.com, jak dziesięć modeli poradzi sobie z jednym bohaterem. Marek miał 35 lat, krótką ciemną brodę, okrągłe okulary, rozczochrane brązowe włosy i musztardowy sweter. Do tego cztery miejsca akcji: kawiarnia, przejażdżka rowerem, biuro i ulica nocą w deszczu,, identyczny opis i seed, żadnej referencji. Komplet plansz opublikowałem w teście spójności dziesięciu modeli.
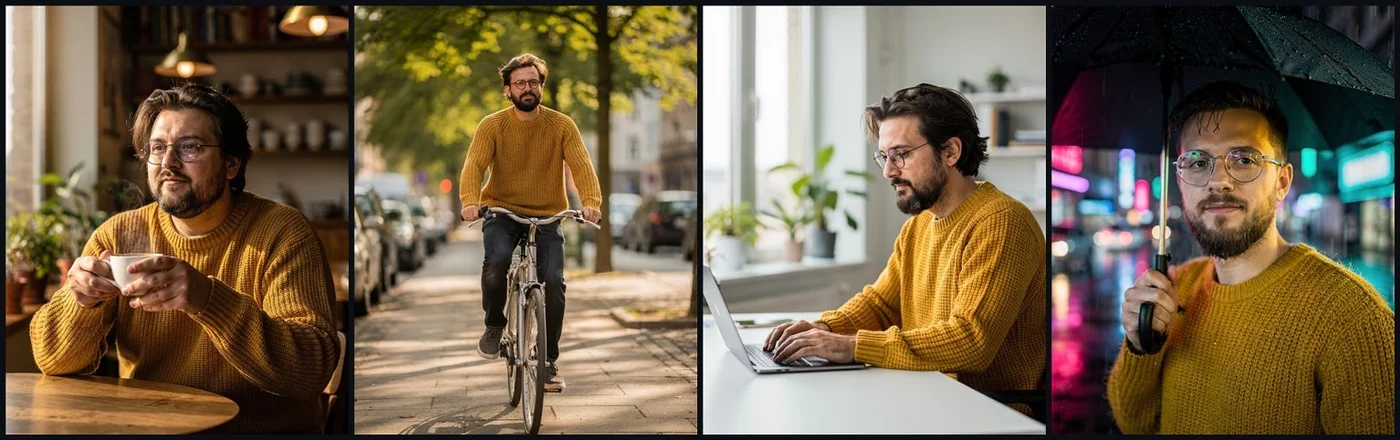
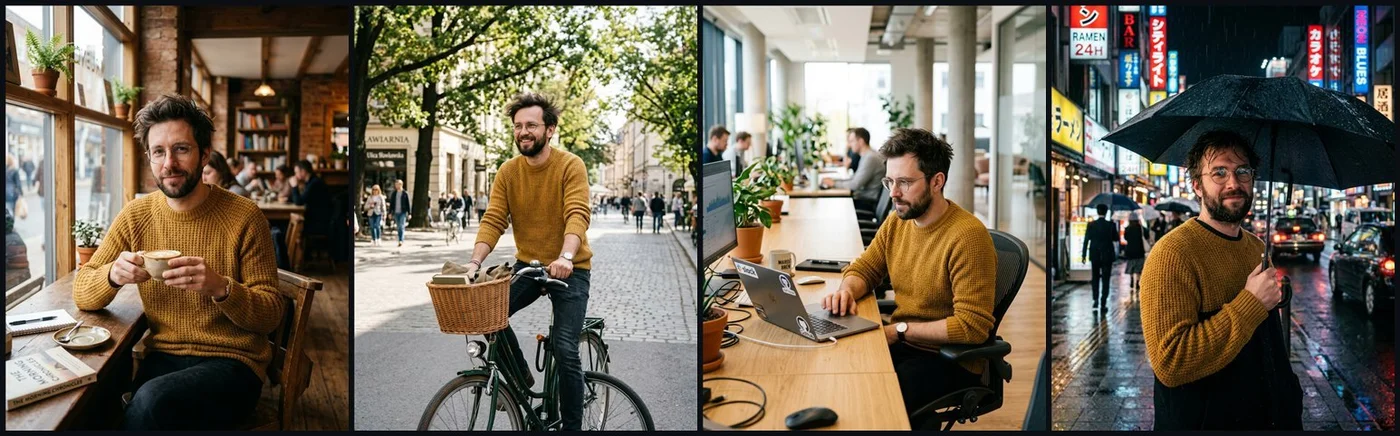
Wyniki:
- Stałe elementy wyglądu trzymały się wszędzie. Oprawki, zarost, dzianina i uczesanie przetrwały każdą zmianę sceny. Ten poziom spójności modele mają już opanowany.
- Z twarzą było różnie. Pierwsze miejsce zajął Seedream 4.5, tuż za nim byli Photon oraz FLUX.2 [pro], a GPT Image 2 zgubił trochę rysów w nocnym deszczu.
- Najsłabiej poszło Nano Banana 2, mimo że producent chwali go za spójność. Przy kawie, na rowerze i pod parasolem dał mi trzech różnych facetów w identycznym swetrze.
Z samego opisu dostajesz więc kogoś podobnego. Tę samą osobę daje dopiero referencja.
Praca w czterech krokach
Krok 1. Arkusz postaci
Zaczynam od jednego obrazu, który od tej pory jest wzorem. Najlepiej sprawdza się arkusz: twarz na wprost, profil i cała sylwetka na gładkim tle, w równym świetle. Z niego biorą wygląd i modele obrazu, i modele wideo.
Character sheet of the same man on a plain light grey background, even studio light:
front close-up, left profile close-up, full body standing. 35 years old,
short dark beard, round thin metal glasses, messy brown hair, mustard knitted sweater,
dark jeans, white sneakers. Realistic photo, no text.
Na ten krok wybieram model z najlepszymi twarzami, np. Nano Banana Pro (od 0,411 zł za obraz). Robię kilka wersji, wybieram jedną i od tej chwili jej nie ruszam.
Krok 2. Opis, który się nie zmienia
Do każdego promptu wklejam ten sam fragment tekstu o postaci, bez przeredagowania. Jeśli raz napiszesz "brodacz w okularach", a raz "mężczyzna z zarostem", model dostaje dwie różne wskazówki. Bohater dostaje imię, a w opisie są tylko rzeczy stałe: wiek, twarz, włosy, ubranie. Scenę, akcję i światło piszę w osobnej części promptu.
Krok 3. Sceny z referencją
Arkusz wgrywam do image_urls (w Studio pole Obrazy referencyjne (URL) i przycisk Wgraj plik), a w prompcie wyjaśniam, kim jest osoba z obrazu:
curl "https://kadraris.com/v1/generate?wait=60" \
  -H "Authorization: Bearer $KADRARIS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-pro",
    "input": {
      "prompt": "The man from the reference image, same face, beard, glasses, hair and mustard sweater. He rides a bicycle down a tree-lined street in autumn, late afternoon sun, 50mm lens, realistic photo.",
      "image_urls": ["https://example.com/marek-arkusz.png"],
      "aspect_ratio": "16:9",
      "resolution": "1k"
    }
  }'
Proporcje podaję jawnie, bo bez nich Nano Banana Pro bierze format z pierwszej referencji. Każdą scenę zestawiam z arkuszem i patrzę na oczy, nos i linię szczęki.
Krok 4. Ruch
Przy wideo wybieram jedną z dwóch dróg:
- Pierwsza klatka w
image_url. Scena z kroku 3 otwiera klip, a prompt mówi tylko o ruchu. To najpewniejsza metoda, bo klip zaczyna się od piksel w piksel twojego kadru. Opisałem ją w poradniku o filmie AI ze zdjęcia. - Referencje w
image_urls. Model buduje scenę od początku, ale postać wygląda jak na obrazach. Więcej swobody w kadrze, mniej pewności co do twarzy.
Drugą drogę sprawdziłem we wrześniu 2026 na Kling 3.0 Omni, poza Studio (tego trybu Klinga w Kadrarisie nie ma). Jako wzór dałem kadr z wcześniejszego klipu z kobietą siedzącą przy stole w kuchni. W poleceniu miała się podnieść, przejść do okna i wypowiedzieć jedno zdanie. Model zrobił wszystko po kolei, a twarz, uczesanie i sweter odpowiadały wzorowi. Problem był jeden: kwestia padła, gdy bohaterka była odwrócona tyłem, więc synchronizacji warg nie sprawdziłem. Całość opisałem przy okazji Kling 4.0 Omni Reference.
Limity referencji w modelach
Dane z katalogu Kadrarisa. Modelem obrazu robisz arkusz i sceny, modelem wideo ruch.
Modele obrazu:
| Model | Max referencji | Pole seed |
|---|---|---|
| GPT Image 2.5 | 16 | brak |
| Nano Banana Pro | 14 | brak |
| Nano Banana 2 | 14 (przy postaci lepiej 4) | brak |
| Seedream 5.0 Pro | 10 | brak |
| FLUX.2 [pro] | 8 | brak |
| FLUX.1 Kontext [pro] | 4 | jest |
Modele wideo (każdy z poniższych przyjmuje klatkę startową, Kling 3.0 także końcową):
| Model | Max referencji | Pole seed |
|---|---|---|
| Seedance 2.5 | 30 | jest |
| Wan 3.0 | 10 | jest |
| MiniMax H3 | 9 | brak |
| HappyHorse 1.1 | 9 | brak |
| PixVerse V6 | 7 | jest |
| Kling 3.0 | tylko klatki | brak |
Z opisów modeli warto zapamiętać:
- W HappyHorse 1.1 odwołujesz się do referencji w prompcie przez
[Image 1],[Image 2]. W Wan 3.0 piszesz "Image 1", "Video 1", a ByteDance w przykładzie do Seedance 2.5 używa "@Video 1". Przy kilku postaciach takie etykiety bardzo pomagają. - MiniMax H3 dolicza opłatę za referencje od szóstej wzwyż (limit to dziewięć).
- Opis Seedance 2.5 dopuszcza zdjęcia realnych ludzi jako wzór. Inne modele bywają ostrzejsze i ich filtry nie przepuszczą prawdziwej twarzy. Odrzucone zadanie kosztuje w Kadrarisie 0 zł.
Seedance 2.5 potrafi też przedłużyć gotowy klip, zachowując postać, co daje jeszcze jedną drogę do spójności w dłuższej scenie:
Konkretny ruch z twojego nagrania
Kiedy bohater ma wykonać określony ruch (taniec, gest, chód), Kling 3.0 Motion Control łączy zdjęcie postaci (image_url) z twoim nagraniem ruchu (video_url). Fotografia odpowiada za to, kogo widać, a nagranie za to, jak się porusza. Stawka to 1,44 zł za sekundę, liczona od długości nagrania źródłowego.
Do czego naprawdę służy seed
Seed się przydaje, tylko nie w tym, o co zwykle pytacie. Ten sam seed, prompt i model oddają ten sam obraz. Gdy zmienisz scenę w opisie, twarz i tak odpłynie, co pokazał test z Markiem, gdzie seed był jeden dla wszystkich scen. Ja używam go do:
- drobnych korekt opisu, gdy kadr jest już prawie idealny,
- uczciwych porównań, kiedy sprawdzam wpływ referencji przy niezmienionym seedzie,
- powtarzalnych serii w modelach, które go mają (patrz tabela).
Twarzy seed nie utrzyma. Od tego jest referencja.
Słabe punkty, nawet z referencją
- Profil i plan ogólny dryfują mocniej niż twarz na wprost w zbliżeniu.
- Drobiazgi na ubraniu (napis na koszulce, wzór dzianiny, biżuteria) potrafią wyglądać w każdym ujęciu trochę inaczej.
- Dwie osoby w kadrze potrafią się zlać i np. broda jednej trafia na drugą.
- Im dłuższy klip (20-30 s), tym więcej czasu na powolne przesunięcie rysów.
- Wyraz twarzy i wiek przesuwają się, gdy prompt każe pokazać silną emocję.
Dlatego w każdej serii planuję zapas, zwykle dwa podejścia na ujęcie.
Budżet serii
Przykład: bohater w sześciu ujęciach rolki, po 5 sekund każde.
| Etap | Ilość | Koszt |
|---|---|---|
| Arkusz w Nano Banana Pro | 4 wersje | 4 × od 0,411 zł za obraz |
| Sceny z referencją, ten sam model | 6 scen po 2 próby | 12 × od 0,411 zł za obraz |
| Ruch w Seedance 2.5 z pierwszej klatki | 6 ujęć × 5 s × 2 = 60 s | 60 × od 1,51 zł za sekundę |
Stawka Seedance dotyczy najniższej rozdzielczości, wyższe kosztują więcej (szczegóły na stronie modelu). Cenę zadania znasz, zanim je wyślesz: w Studio na przycisku, w API w estimated_cost. Zadania ze statusem failed kosztują 0 zł. Szersze wyliczenia dla rolek zebrałem w osobnym poradniku o kosztach, a bohatera w klipie muzycznym opisuję w tekście o teledysku AI.
Pytania
Co zrobić, gdy w jednym kadrze są dwie stałe postacie?
Przygotuj osobny arkusz dla każdej i podaj oba jako referencje. W prompcie nazwij je etykietami, np. "the man from Image 1" i "the woman from Image 2". Licz się z tym, że cechy mogą się mieszać, więc zaplanuj więcej prób.
Czy mogę zmienić bohaterowi ubranie, zachowując twarz?
Tak, ale wtedy wyrzuć sweter ze stałego opisu i dopisz nowy strój w części o scenie. Referencja nadal trzyma twarz, a model ubierze postać według tekstu. Detale nowego ubrania mogą się różnić między ujęciami.
Który model wideo wybrać, jeśli mam kilka referencji postaci?
Najwięcej obrazów przyjmuje Seedance 2.5 (do 30), potem Wan 3.0 (do 10), MiniMax H3 i HappyHorse 1.1 (do 9). Jeśli wystarczy jedna klatka startowa, każdy model z tabeli z pierwszą klatką da radę.
Czy wolno mi użyć zdjęcia prawdziwego człowieka jako wzoru?
Tylko za zgodą tej osoby i tylko w modelach, które to przyjmują. Jeśli filtr odrzuci zadanie, nie płacisz za nie. Pierwsze próby zrobisz w Kadraris Studio już po doładowaniu za 40 zł, a niewydane środki zostają na koncie bez terminu.